…
开发者将基于 MiniMax H3 的 HyperFlow Flash 视频生成模型转换为 INT8 格式,利用 ComfyUI 原生 INT8 计算内核加速推理,同时保留文生视频、首帧生成视频、首尾帧控制、参考图生成视频,以及同步立体声音频生成能力。 最值得关注的是速度:仅需
这个话题下写得比较实的几条,点进去看原文。
开发者将基于 MiniMax H3 的 HyperFlow Flash 视频生成模型转换为 INT8 格式,利用 ComfyUI 原生 INT8 计算内核加速推理,同时保留文生视频、首帧生成视频、首尾帧控制、参考图生成视频,以及同步立体声音频生成能力。 最值得关注的是速度:仅需
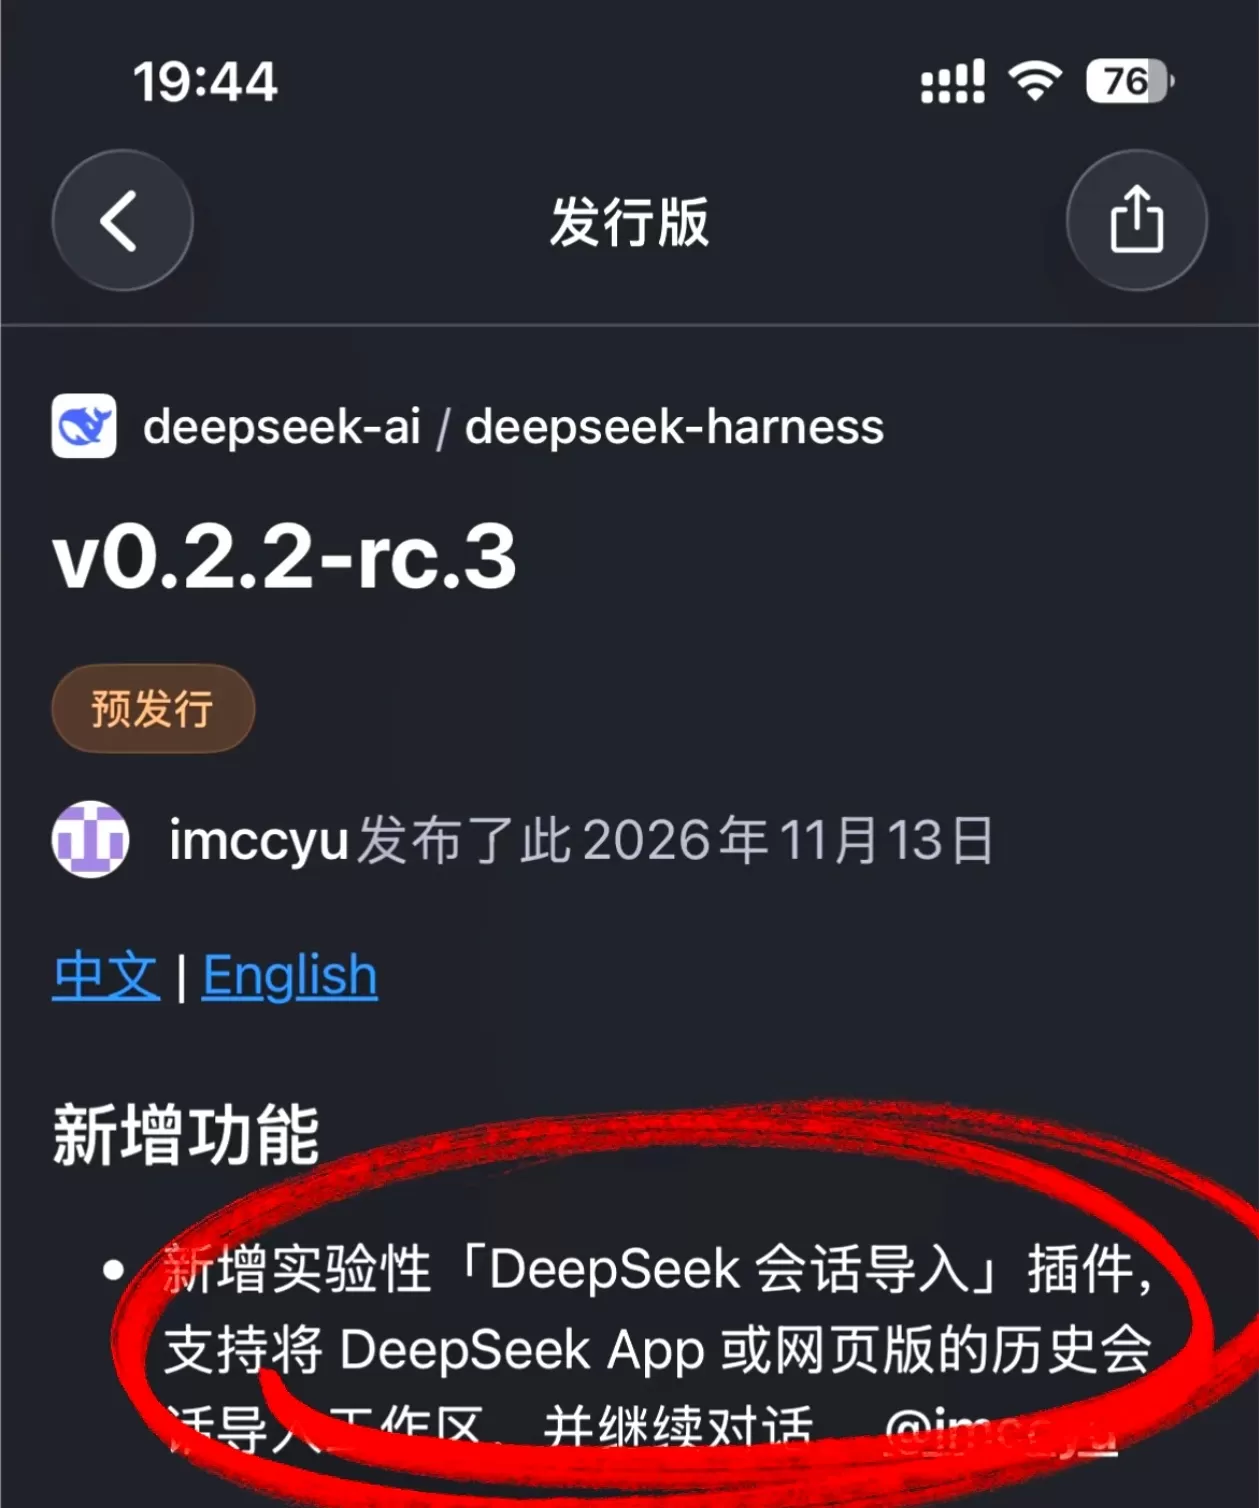
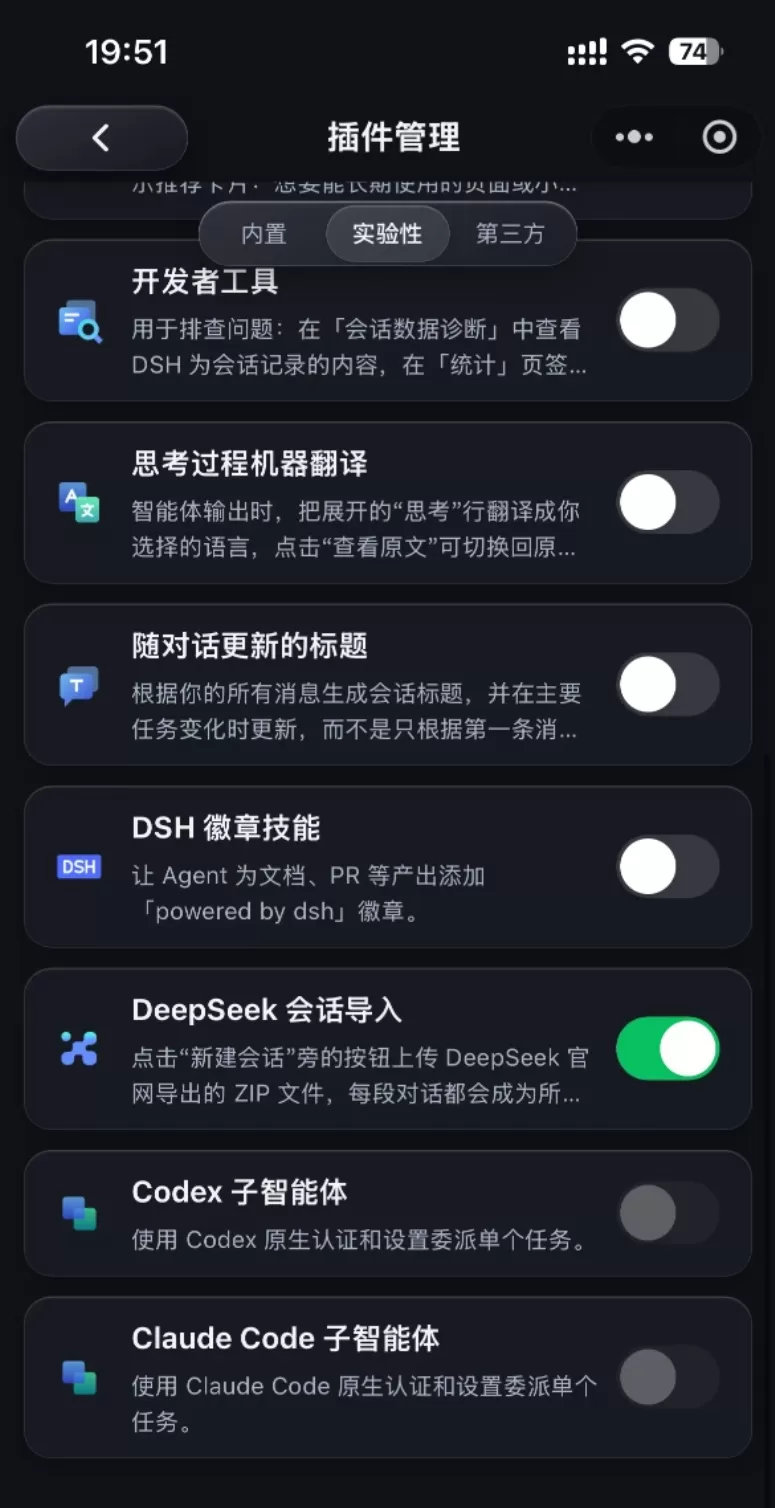
DeepSeek会话超上限、网页会话超出聊天窗口的问题,官方原来是给出了解决方案的。 只要把会话导入DeepSeek Harness里接着用就行。 官方在dsh v0.2.2-rc3更新中新增了网页会话导入的实验性插件,具体操作是:先在电脑上安装dsh或更新到最新的rc3版
 文章
盘点 2026 年最受瞩目的 350+ AI 开源项目,覆盖 AI Agent、LLM 推理、语音合成、视觉模型、RAG 等 13 大领域。
「混元 Hy4 接近 DeepSeek V4.1 Flash」只适合当开场白。搜索引擎和第三方榜单里,真正可写的是 评测选型:自报分数、独立指数、按任务怎么选、API/WorkBuddy 怎么用。
先分清三张表
| | 表 | | 谁写的 | | 怎么读 |
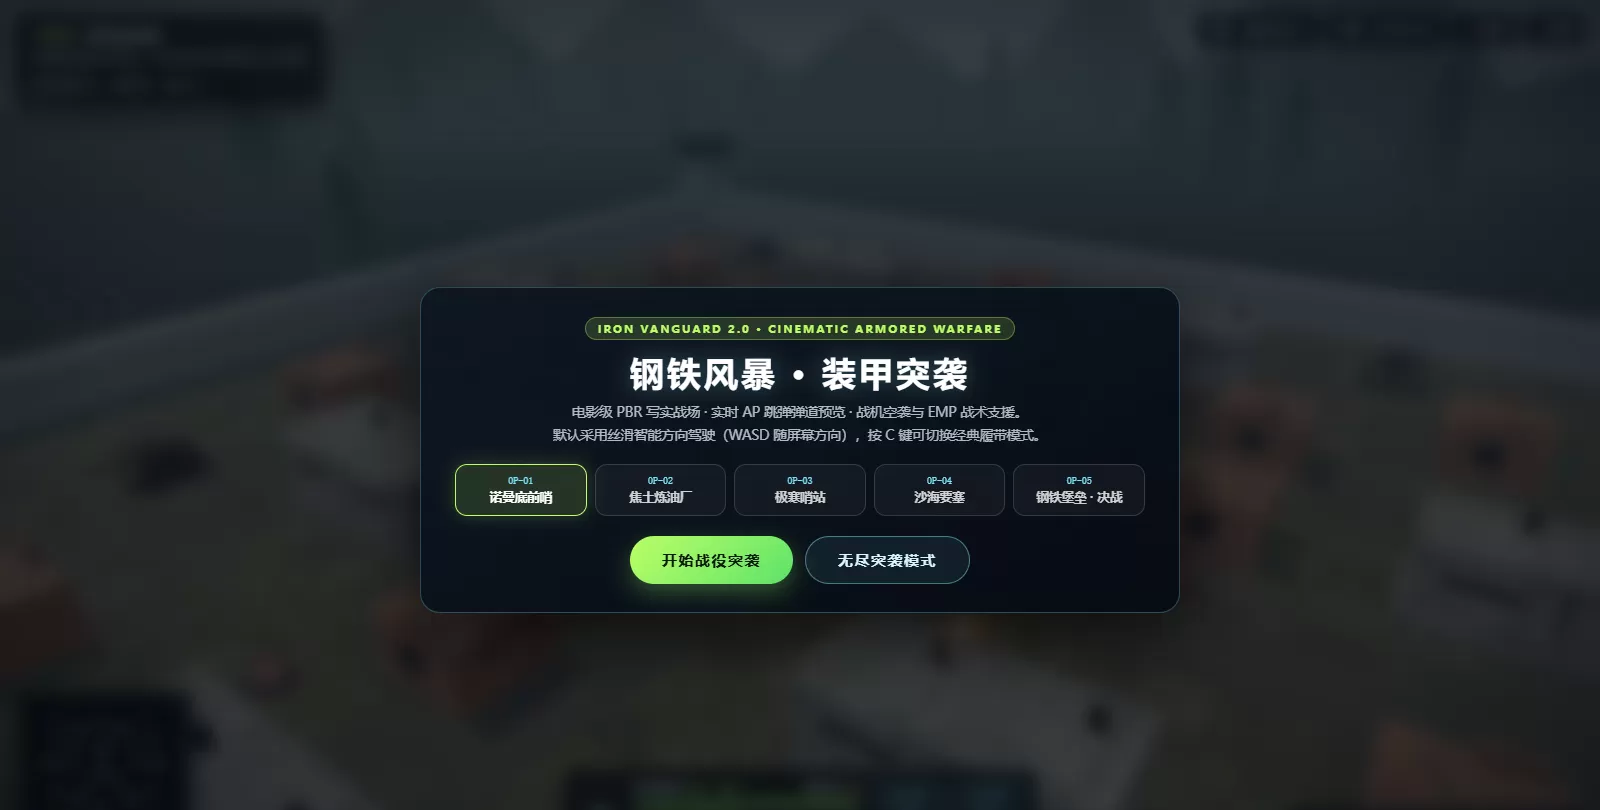
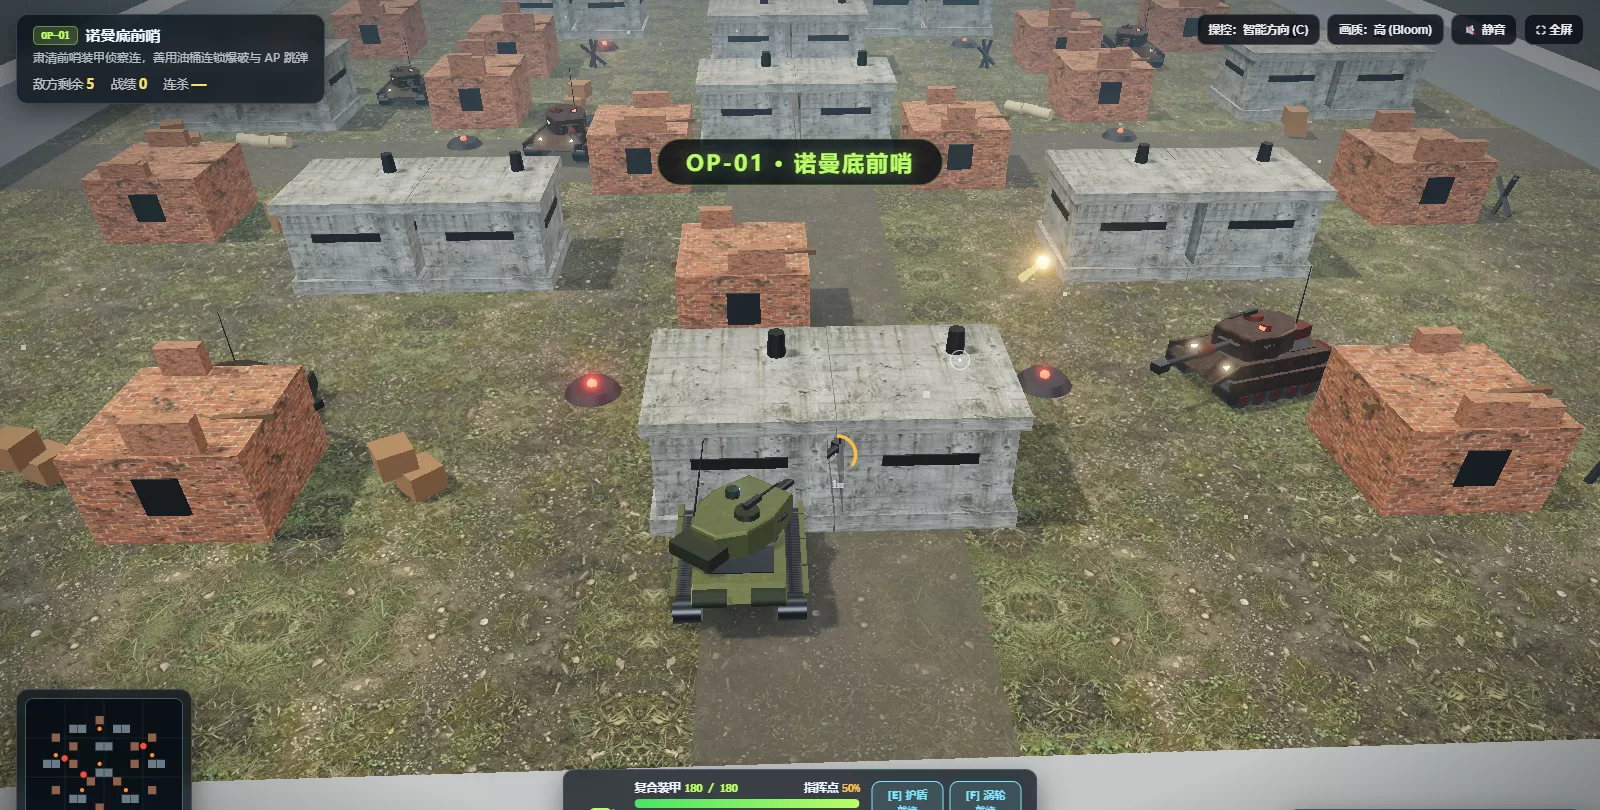
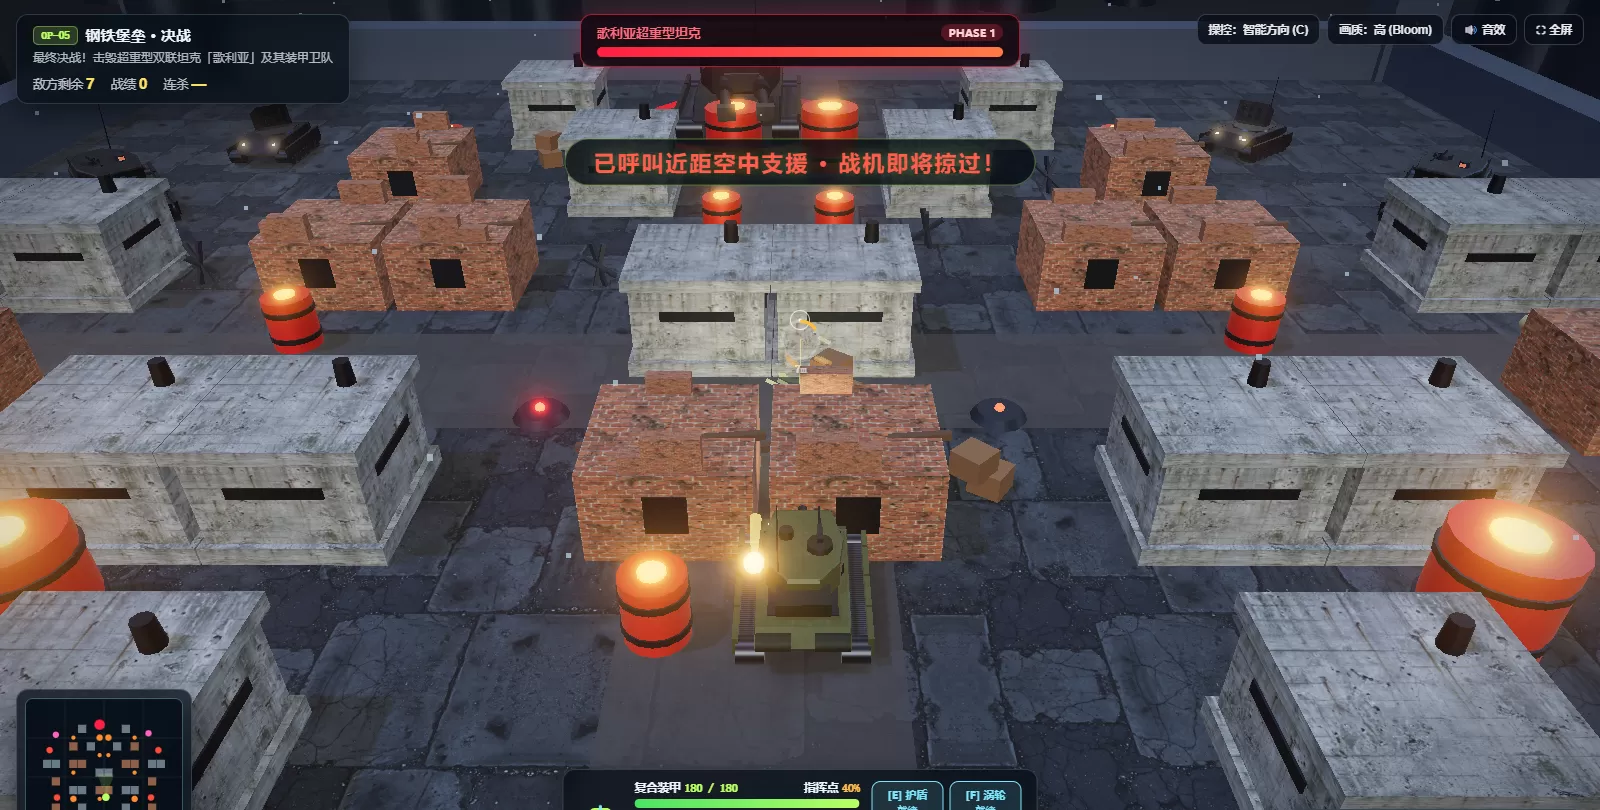
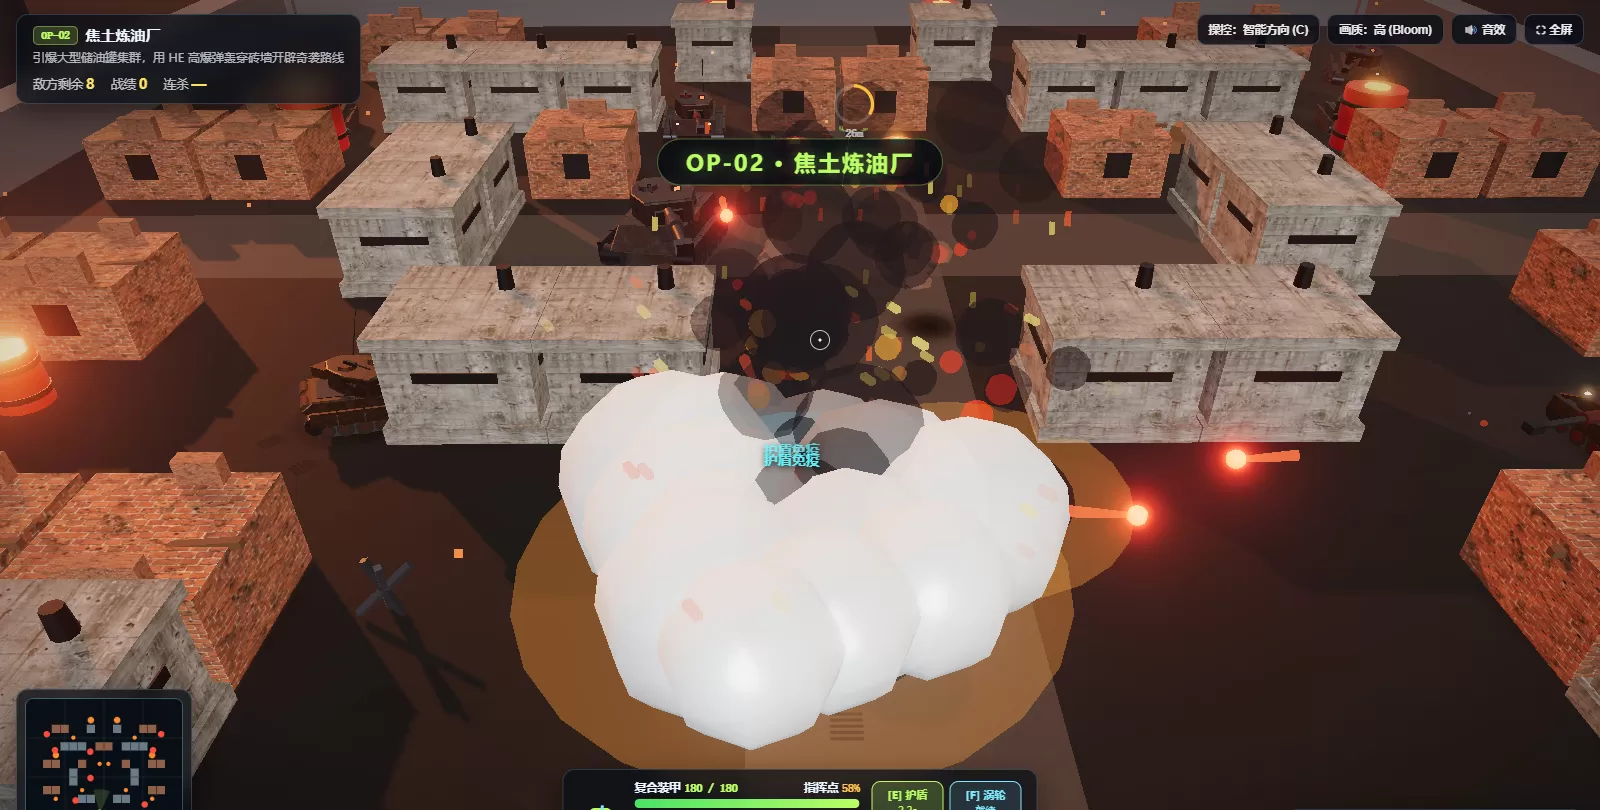
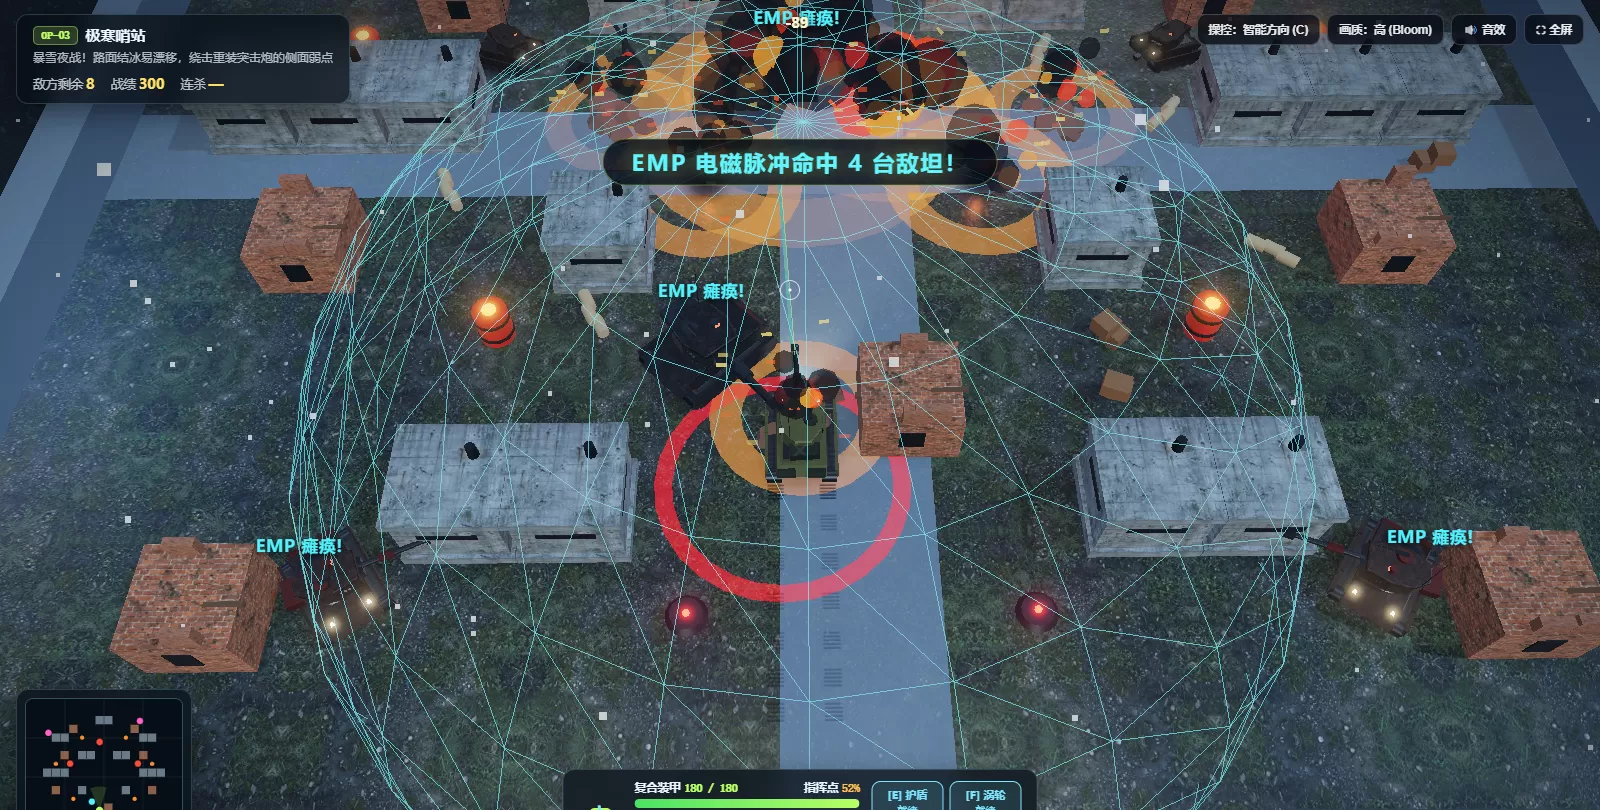
今天用 antigravity + gemini 4 neon。没想到 30 分钟不到,就从零开发了一款超棒的 3d 坦克游戏 “钢铁风暴”。 之前用 AI 写游戏最麻烦的地方就是模块一多就容易乱,还得满世界找贴图素材,但这次开发完全一键搞定。 我先用 antigravit
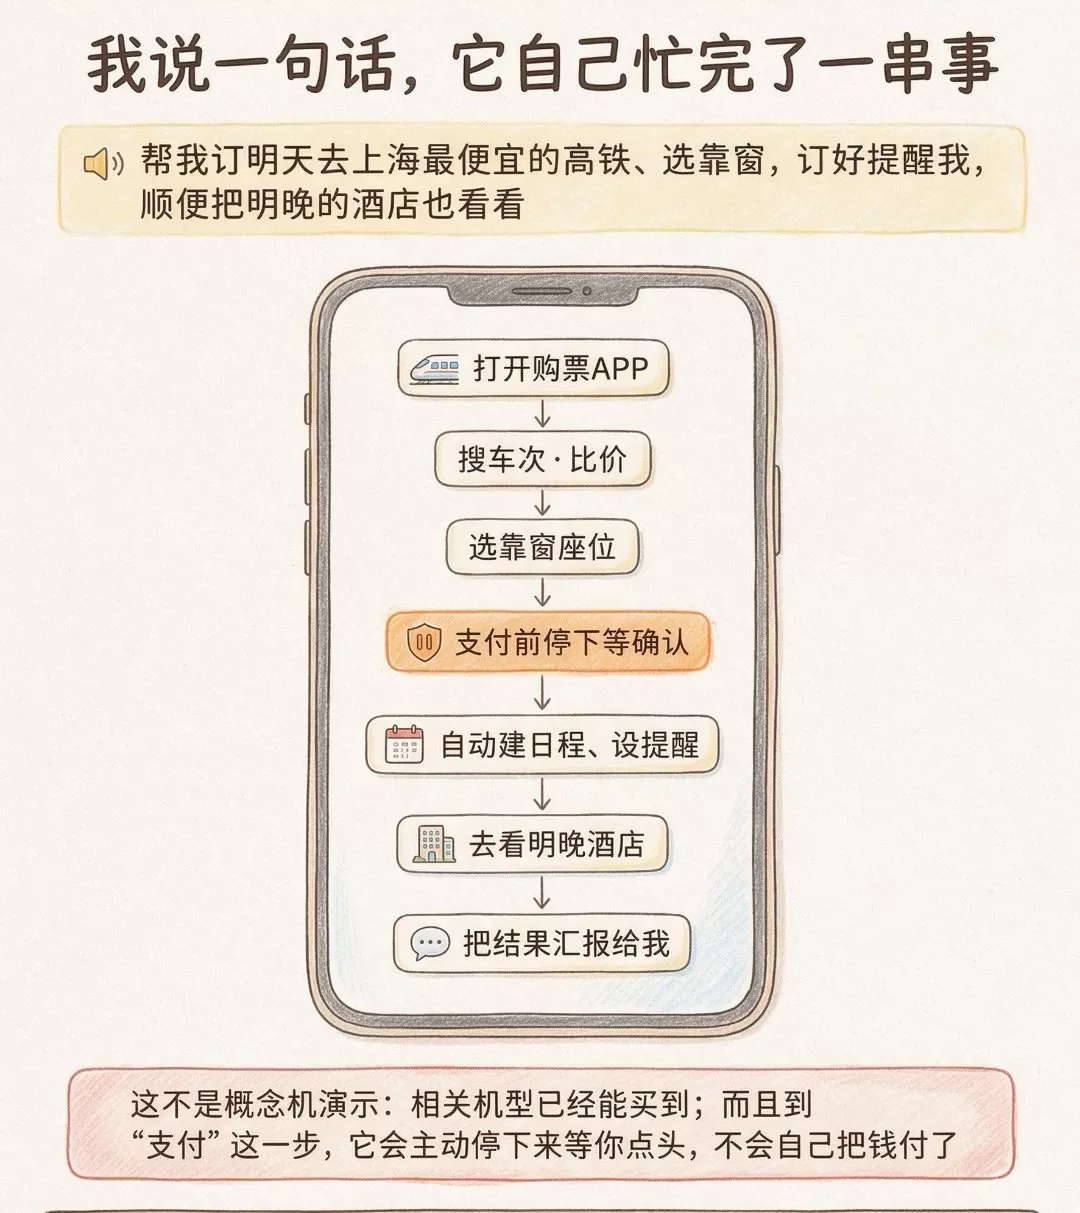
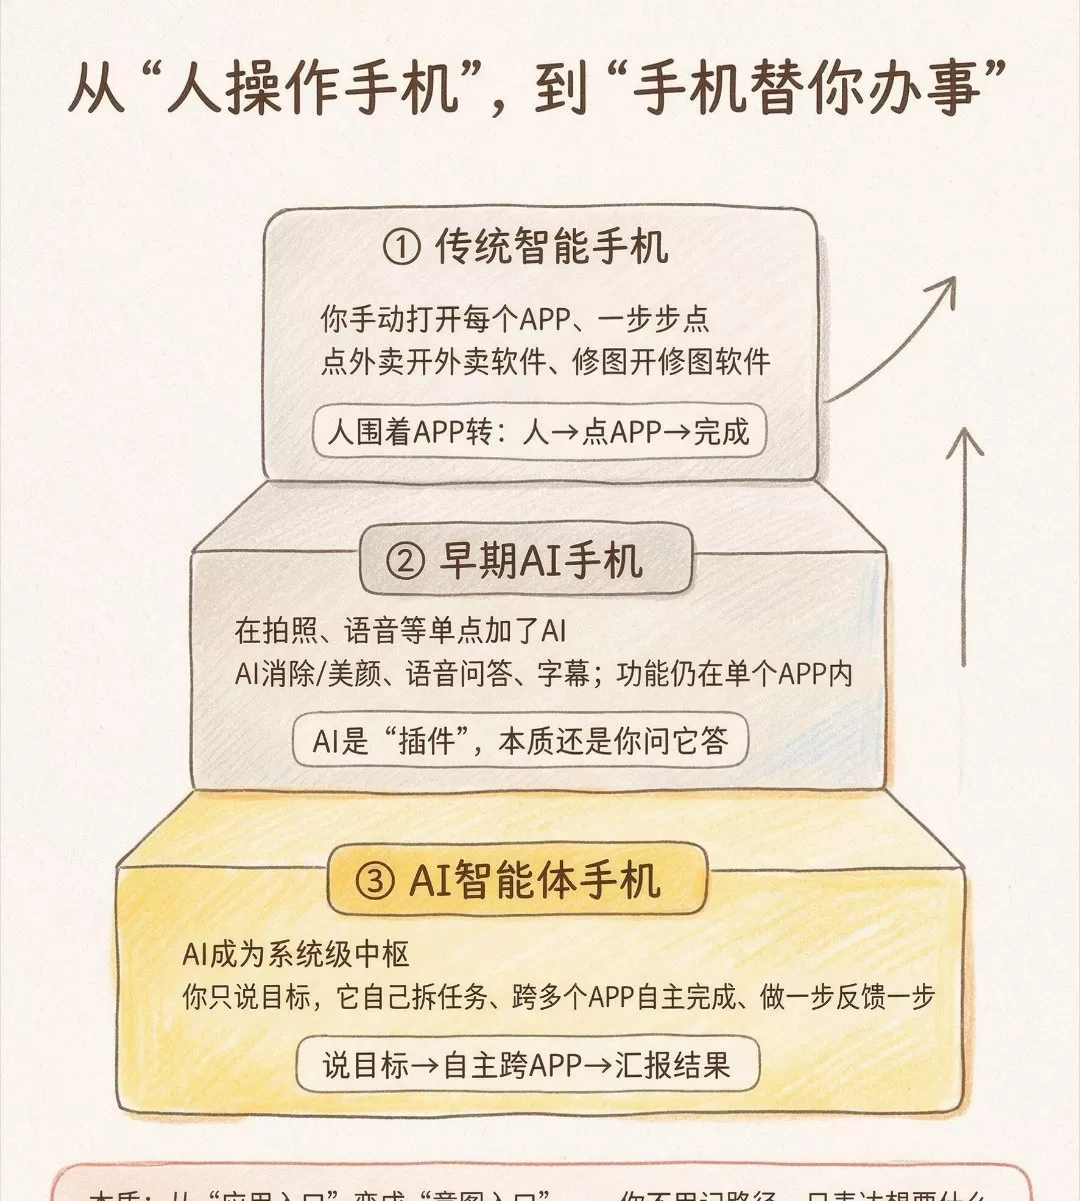
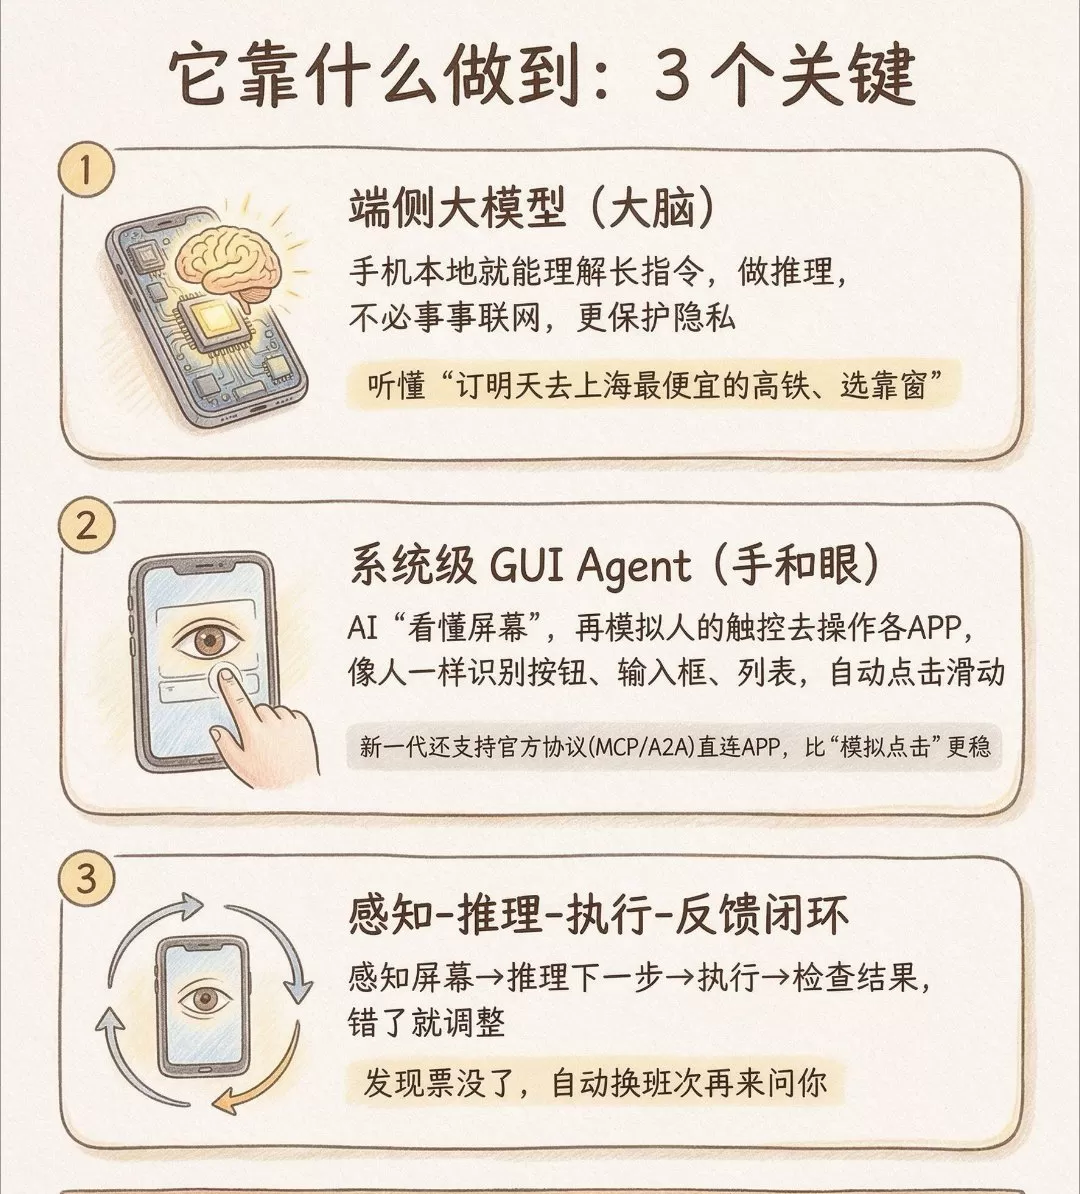
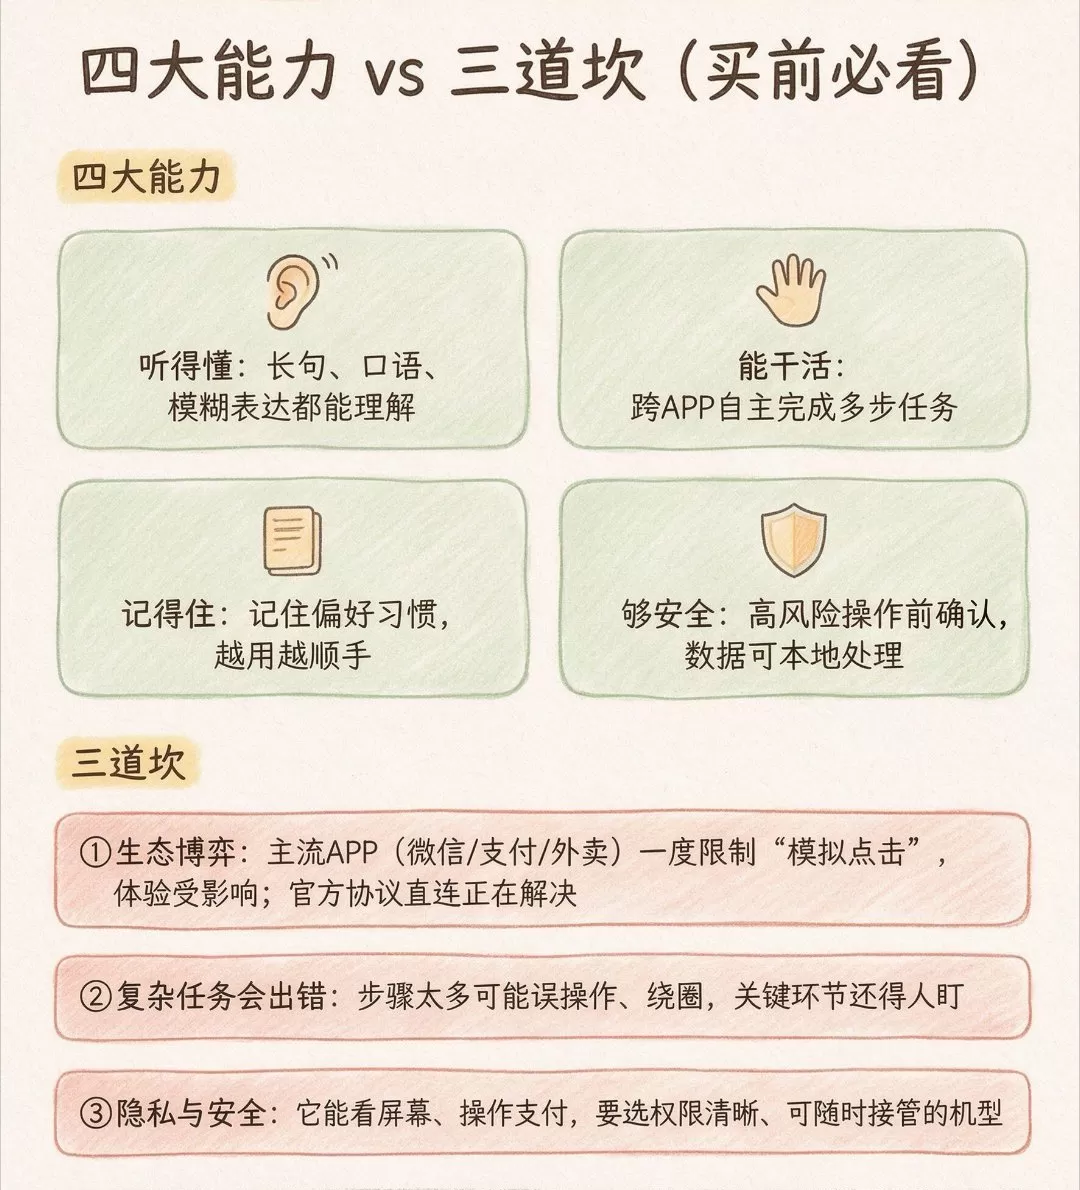
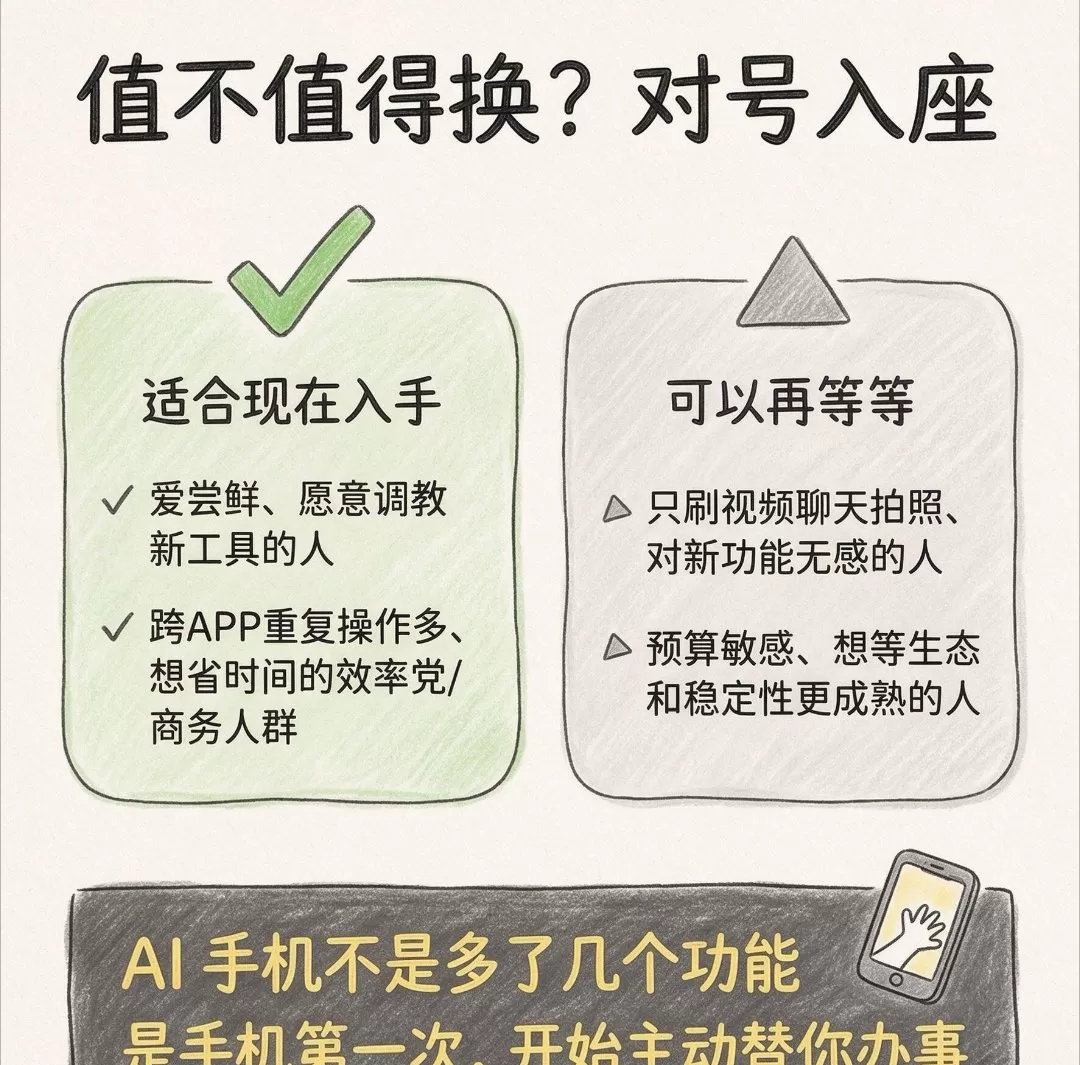
现在手机不止是操作到哪步做哪步,而是能听懂指令、自己把一连串事情办完。 #AI手机 #大模型 #AI工具
11月19日,据每日经济新闻昨日报道,字节跳动旗下AI办公产品豆包工作官方披露数据,产品日活跃用户(DAU)突破800万,企业客户年度经常性收入ARR突破20亿元。 据了解,豆包工作于8月25日正式发布,距今上线约三个月,是面向生产力场景打造的AI办公智能体,可围绕用户目标自主
Hy4 进开源第一梯队:选型看真实场景,别只看一句“对标”
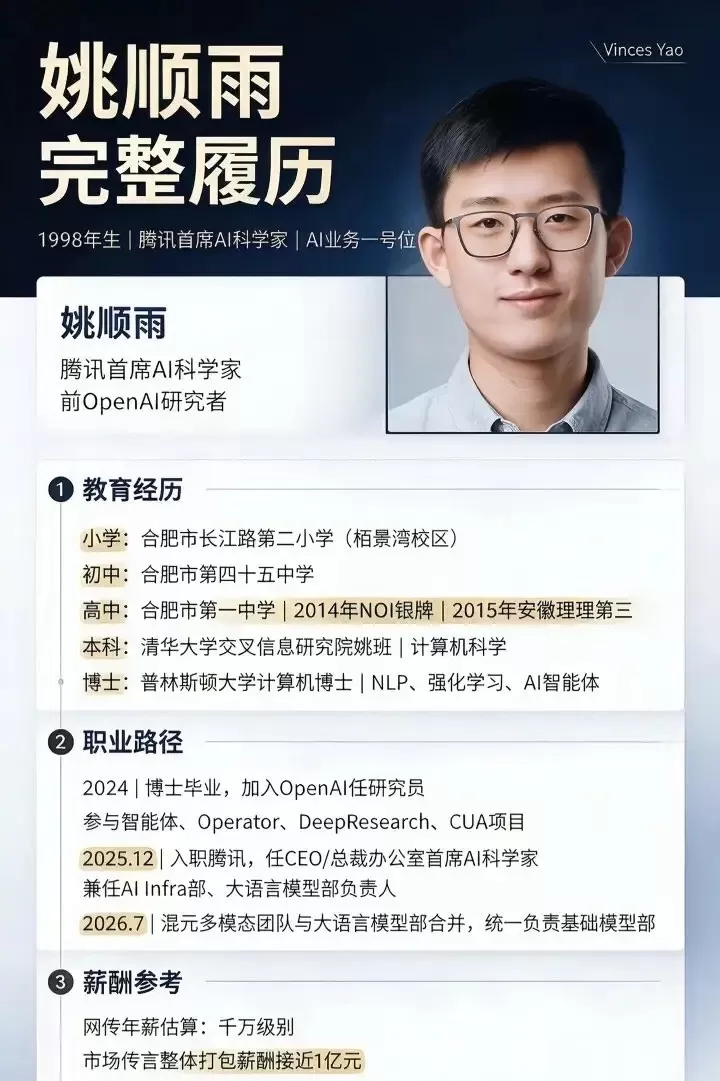
有观察称姚顺雨加盟后,混元 Hy4 很快摸到开源第一梯队。对方自己强调:最自豪的不是榜单,而是安全、有用性、人类评测和泛化,没去一味刷自动化跑分。
构建可信的 AI 基础设施,打造安全可靠的 AI NVIDIA 和网络安全合作伙伴 Eclypsium 正在推进云计算及代理式 AI 的基础设施安全性。 NVIDIA 的内置平台保护和 Eclypsium 的基础设施提供了信任层,用于在驱动 AI 的基础设施中建立并维持信任
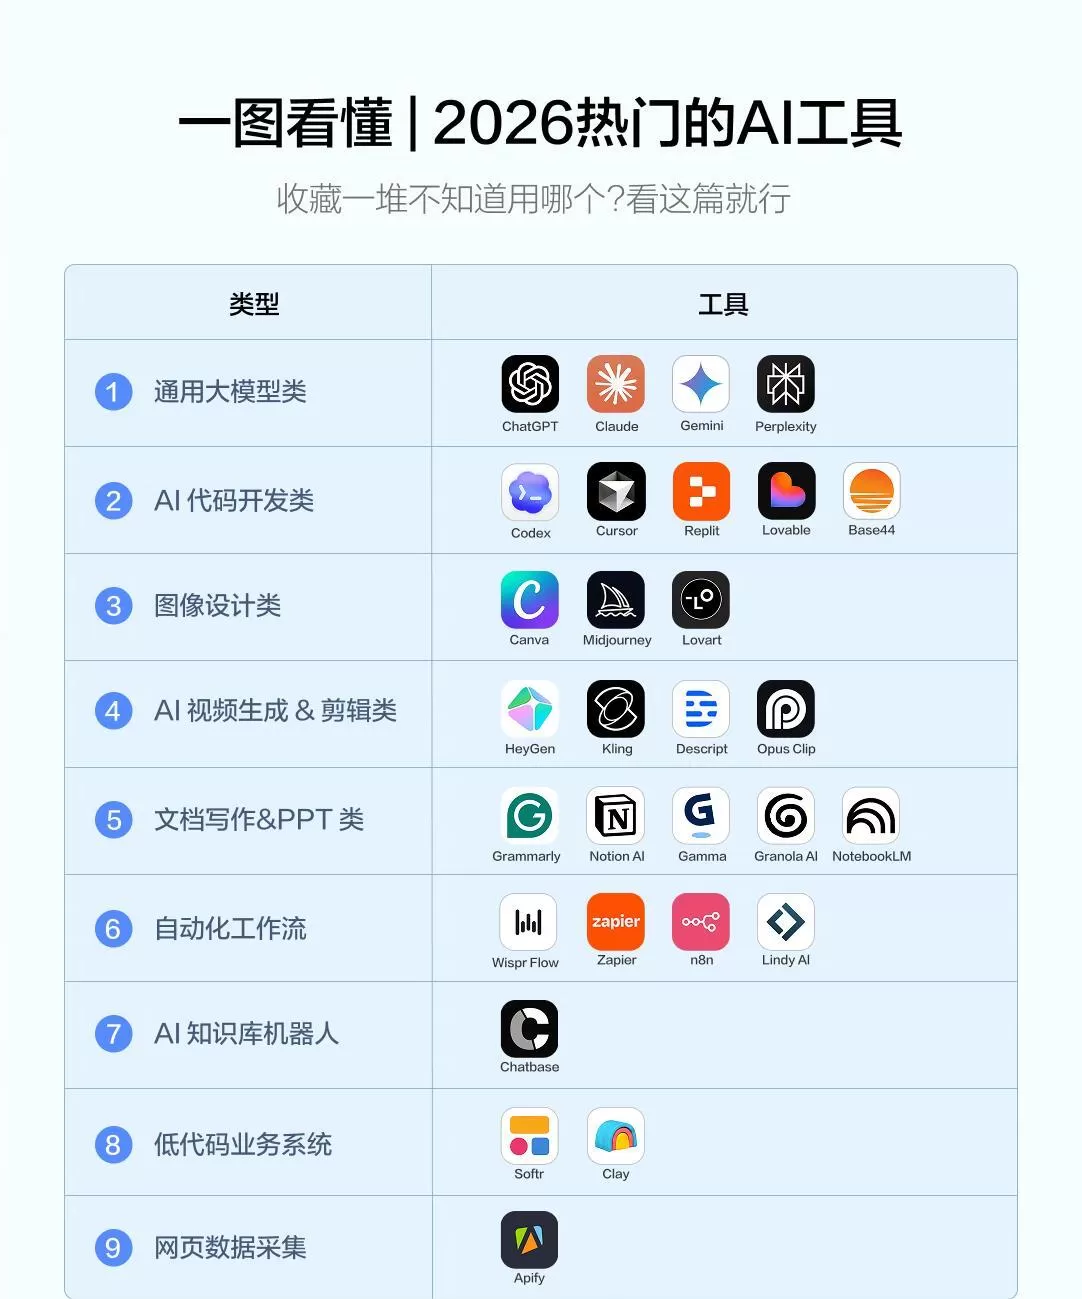
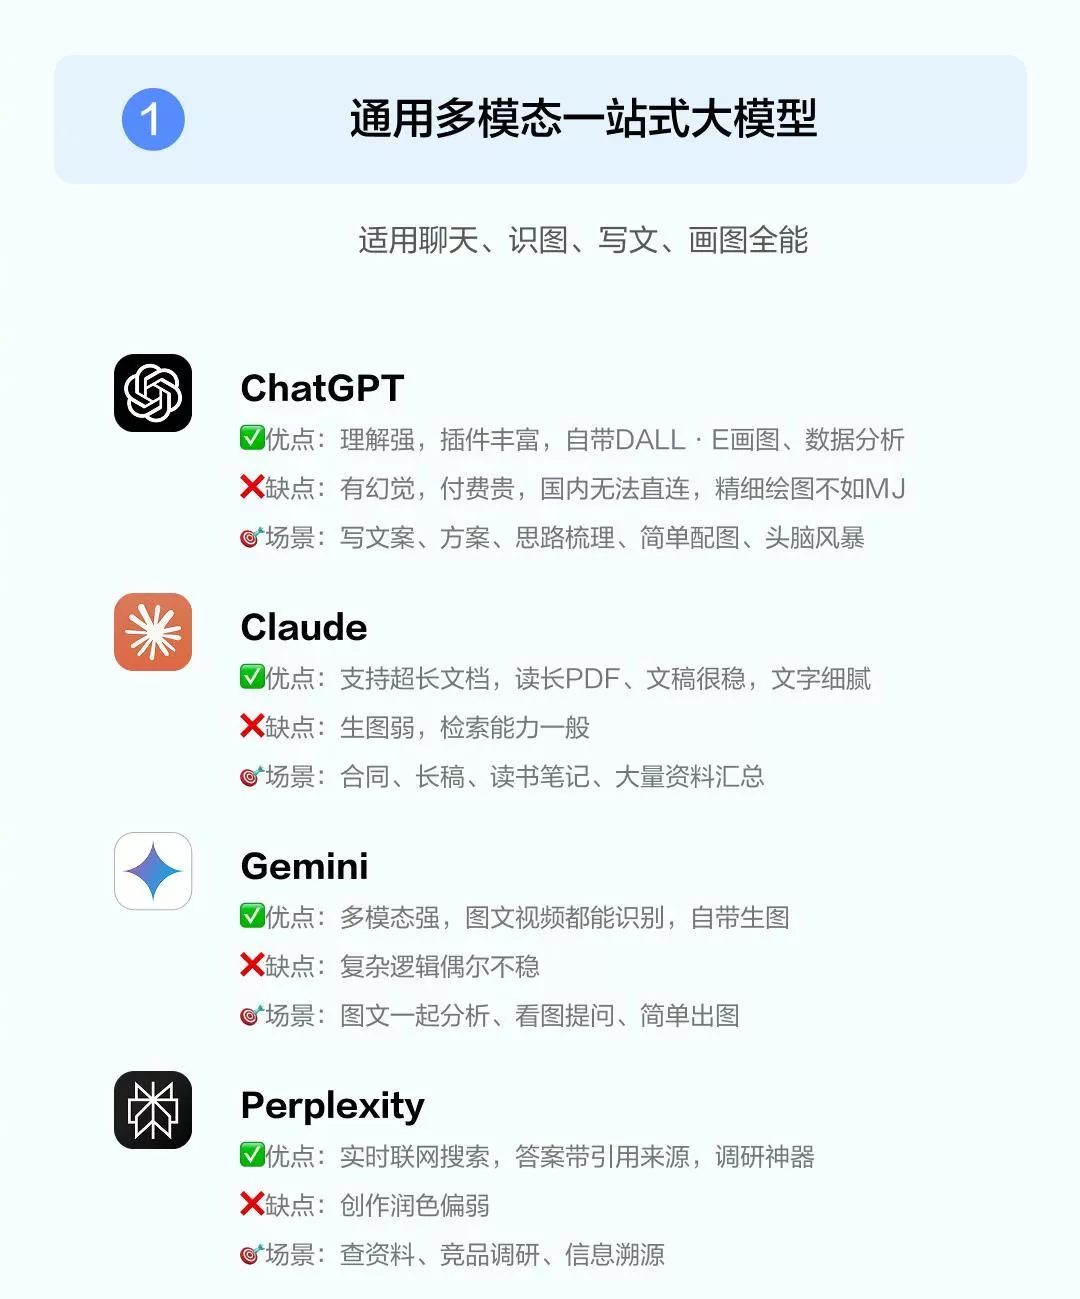
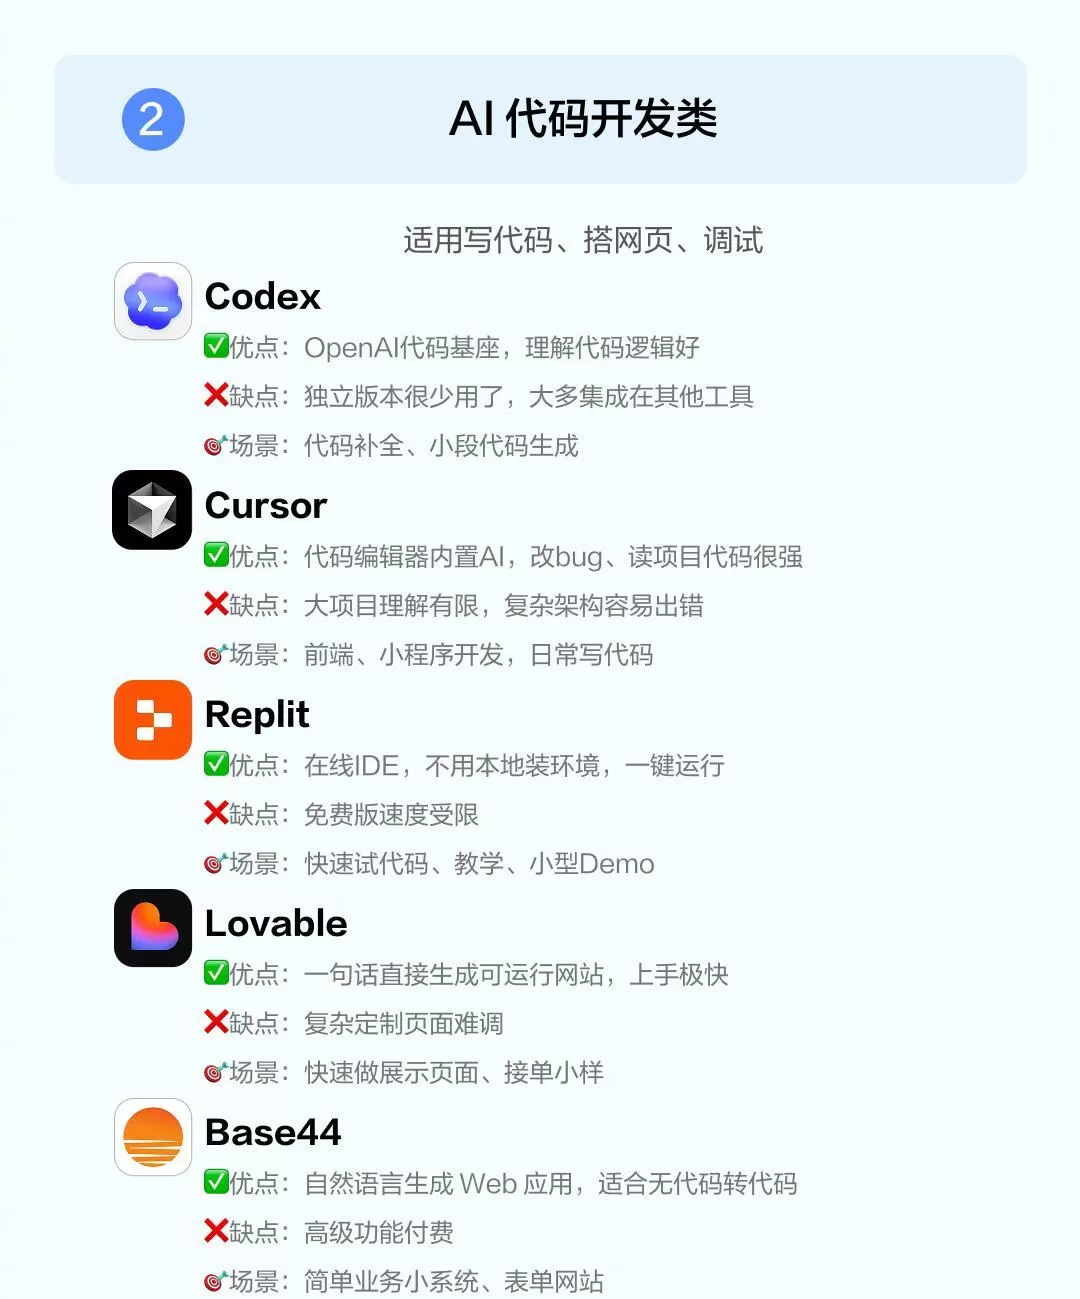
ChatGPT / Gemini / Claude:全能思考大模型,主打文字推理,附带多模态能力 Perplexity:联网 AI 搜索,边查边总结带来源 Codex / Cursor / Replit:AI 写代码,Cursor 主打 IDE 内辅助,Replit 在线跑代
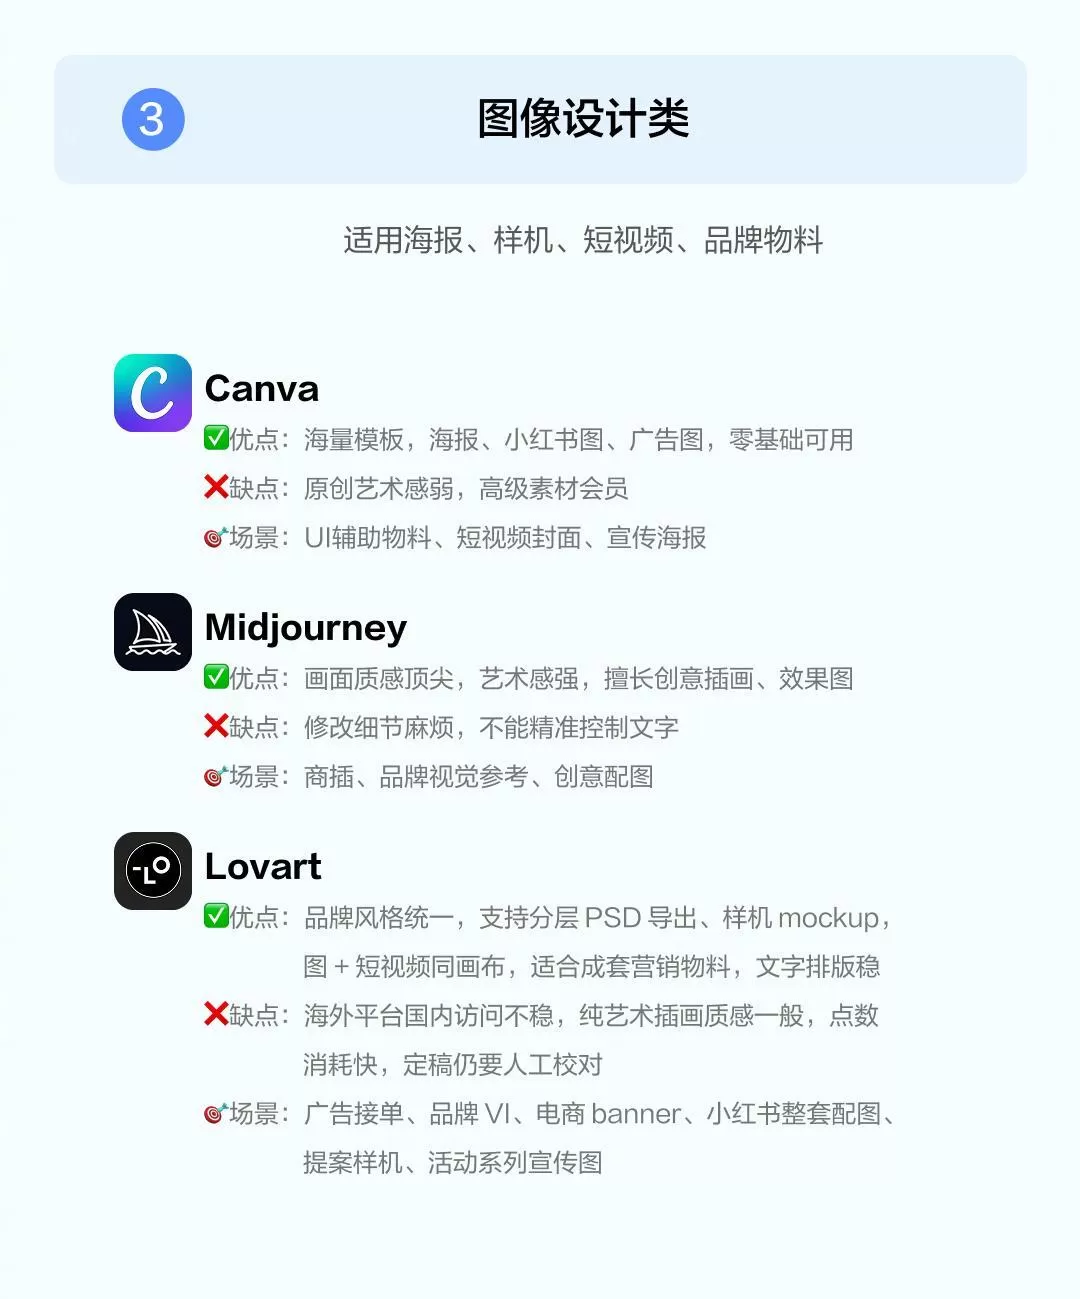
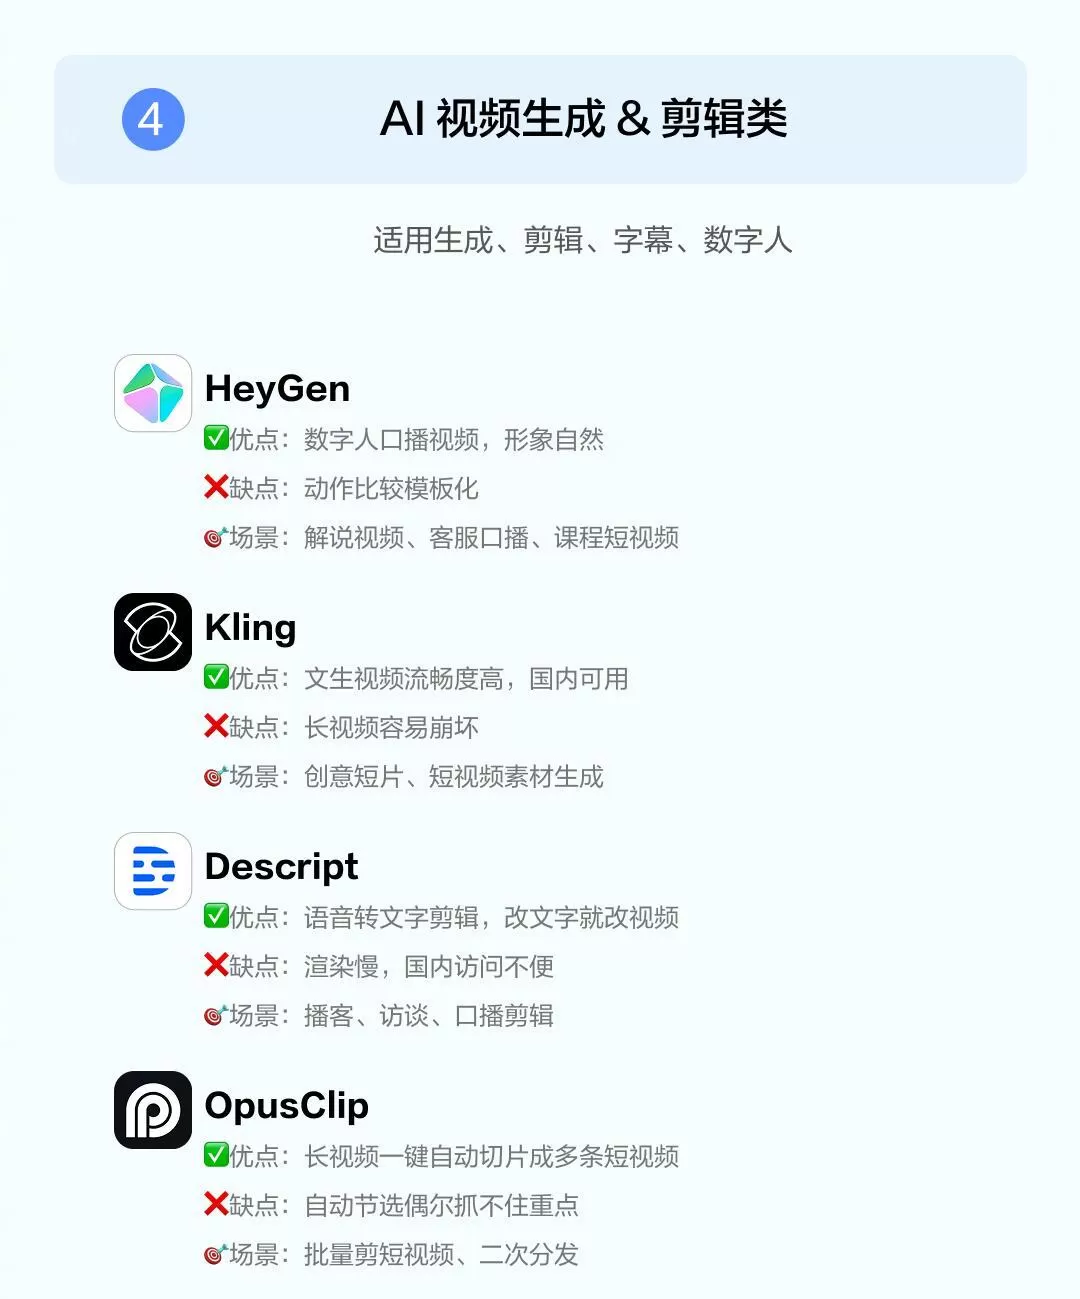
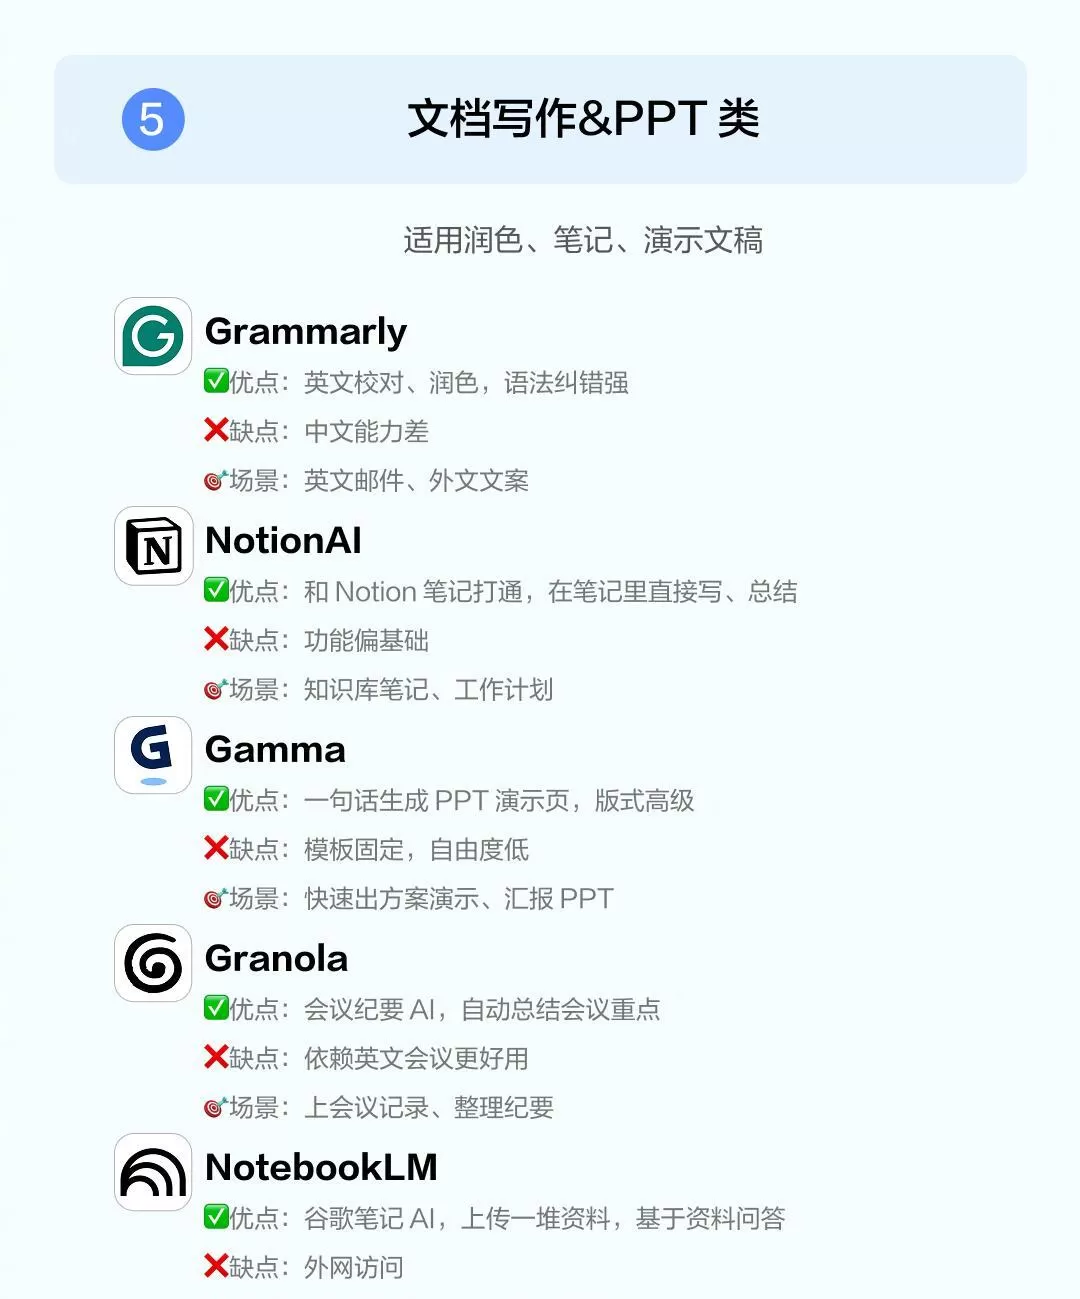
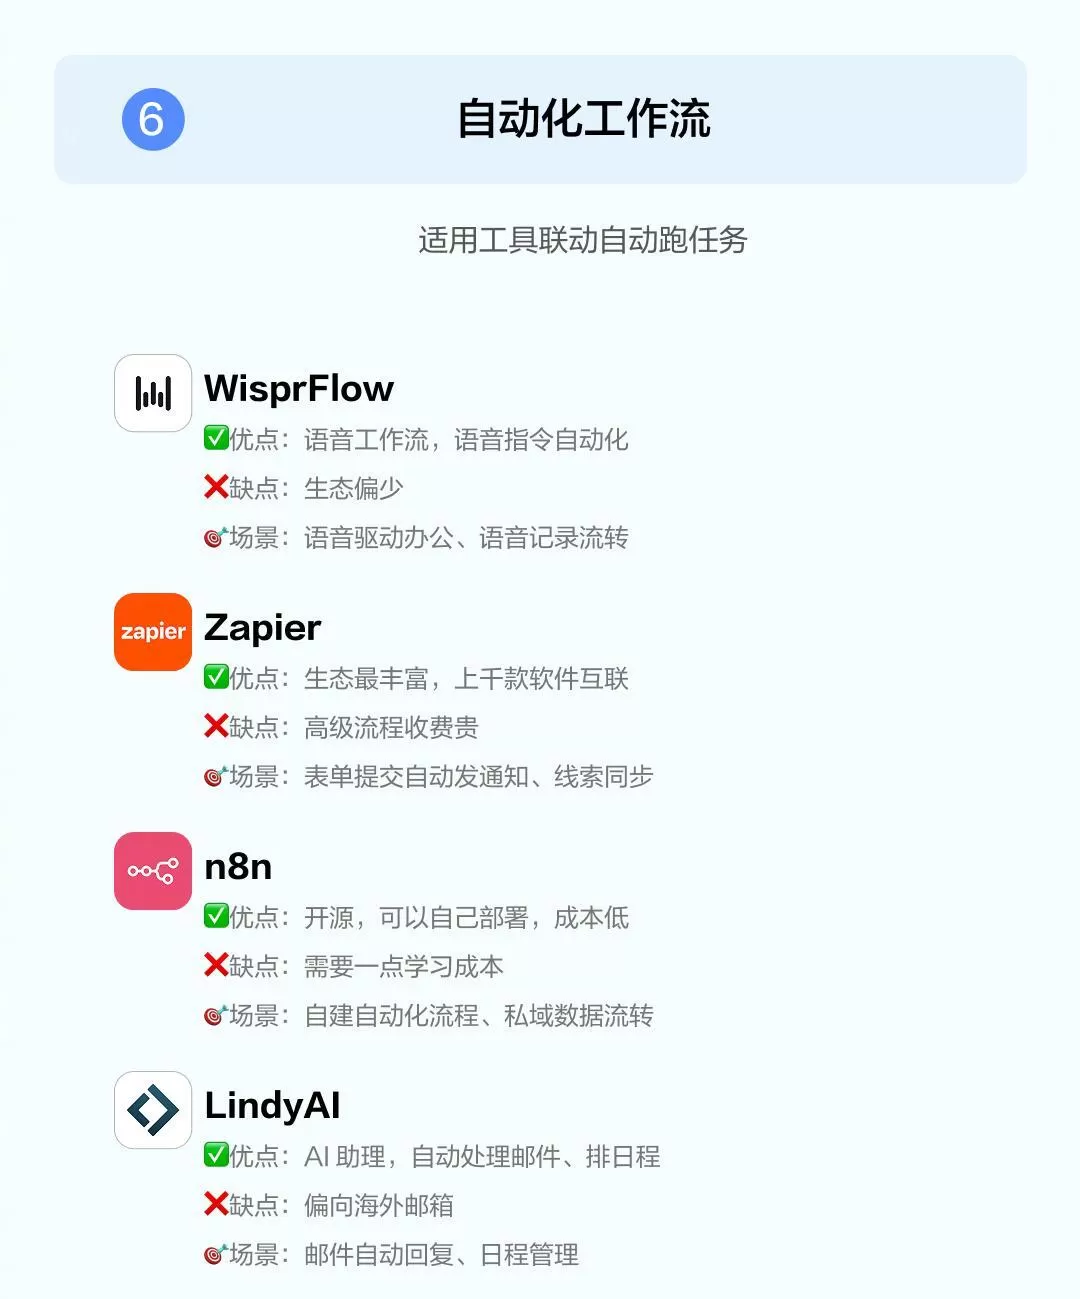
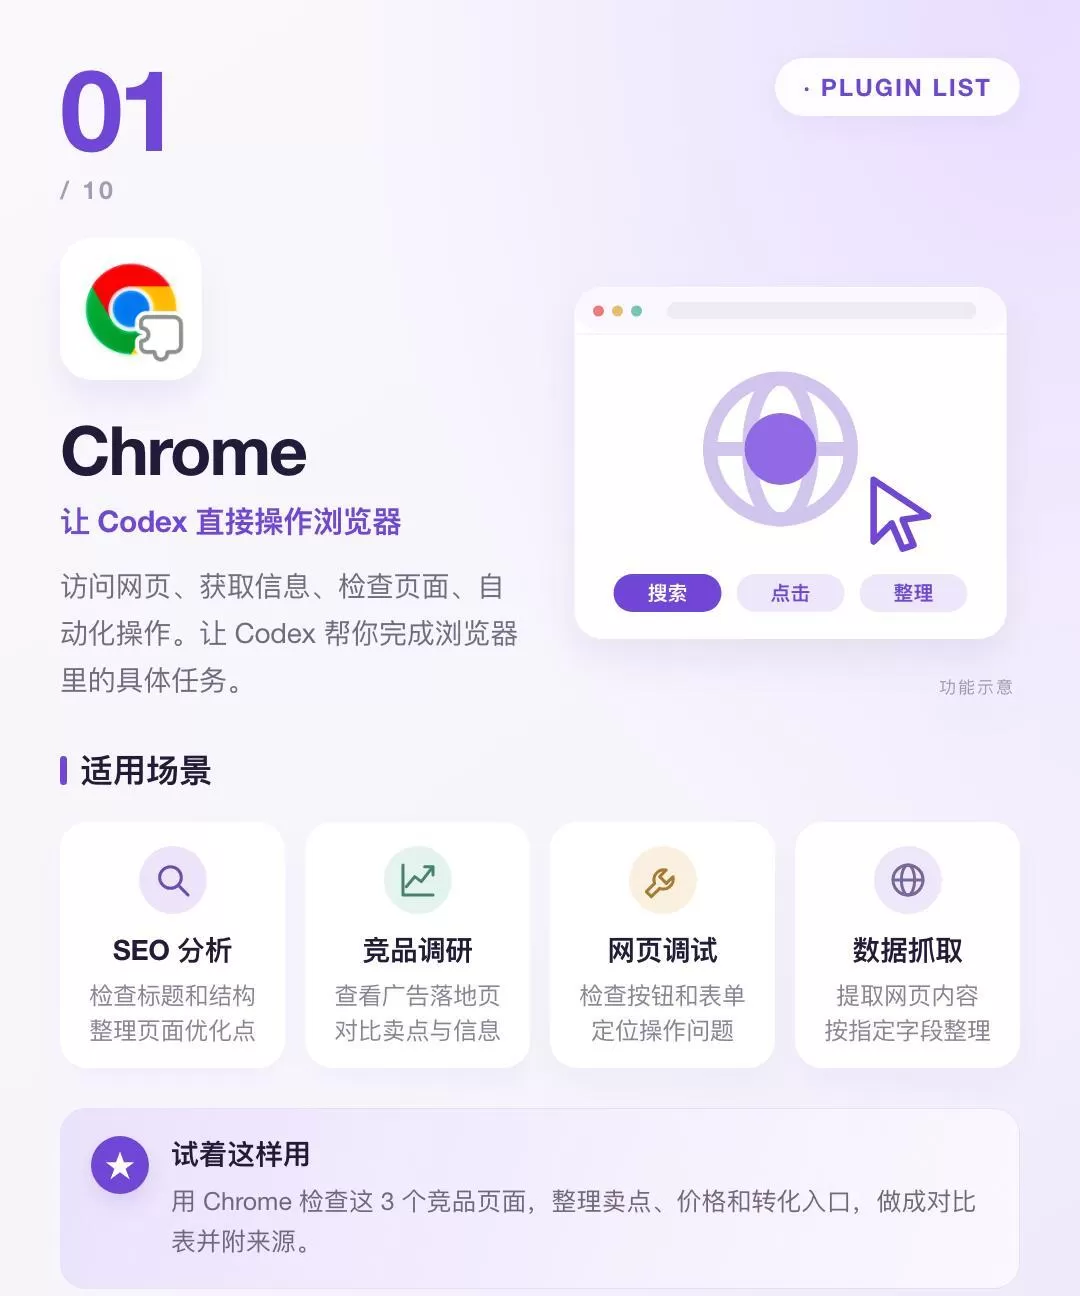
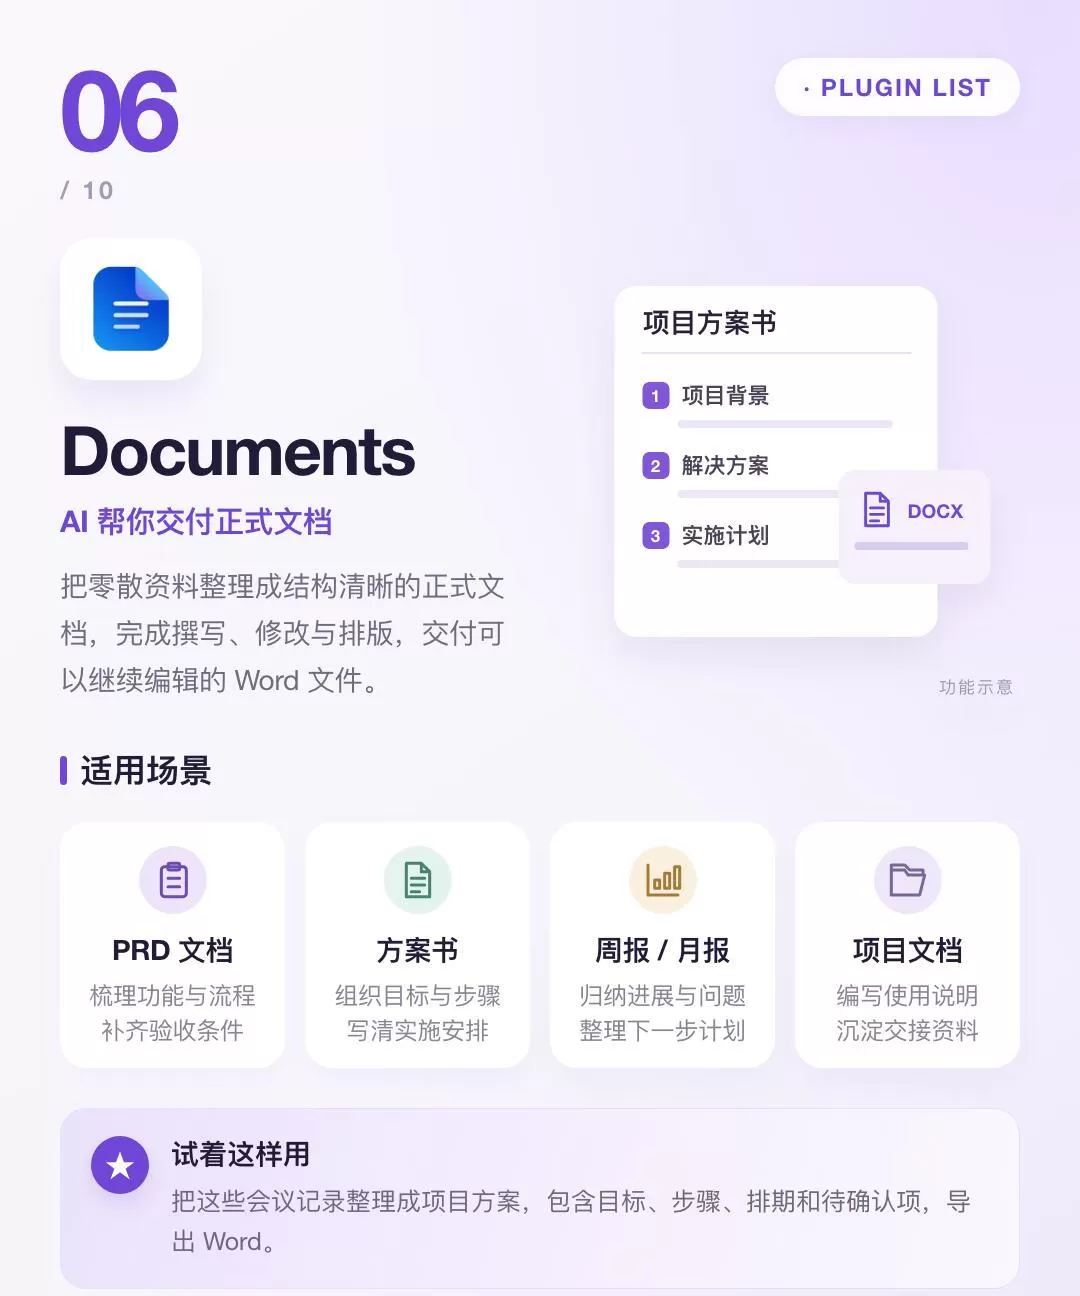
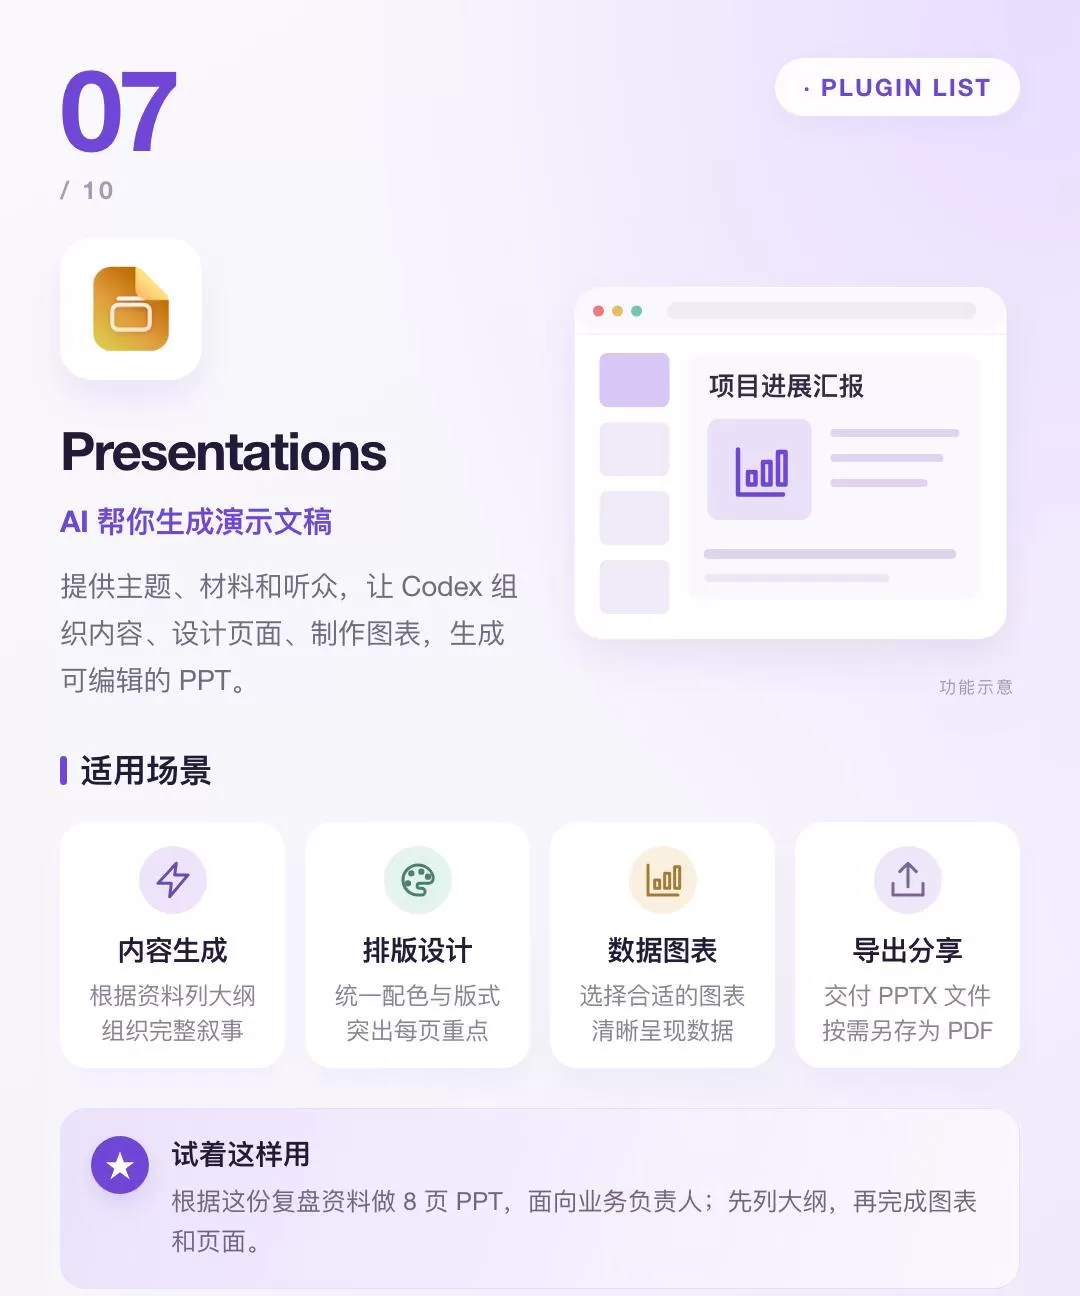
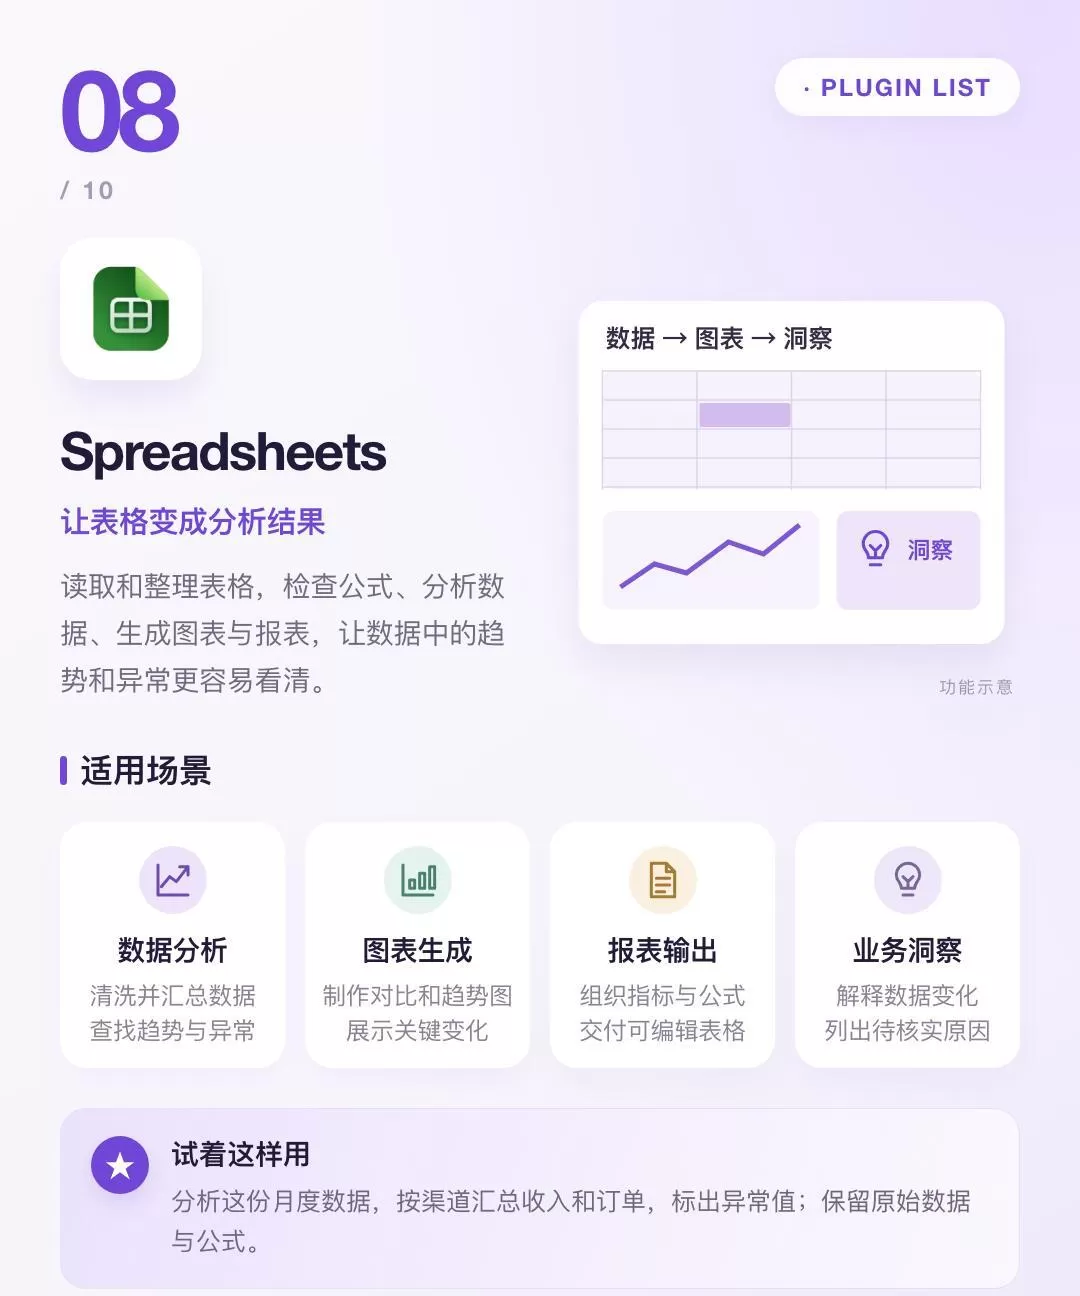
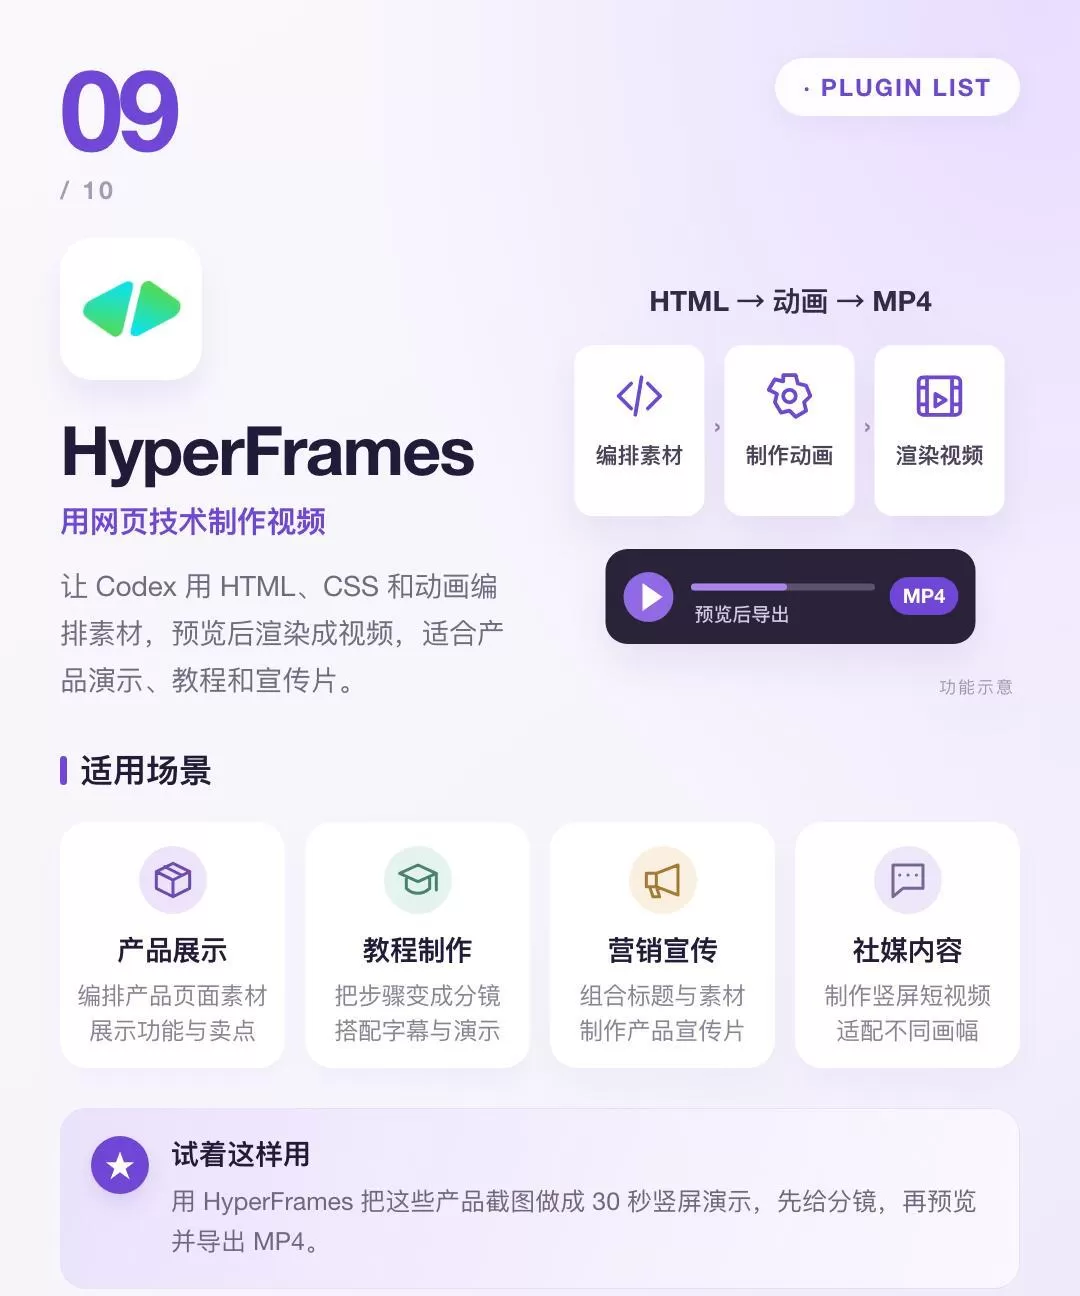
Codex最值得安装的10个插件 这次把 10 个插件的用途、适用场
Codex最值得安装的10个插件 这次把 10 个插件的用途、适用场景和安装入口放进一套图里。
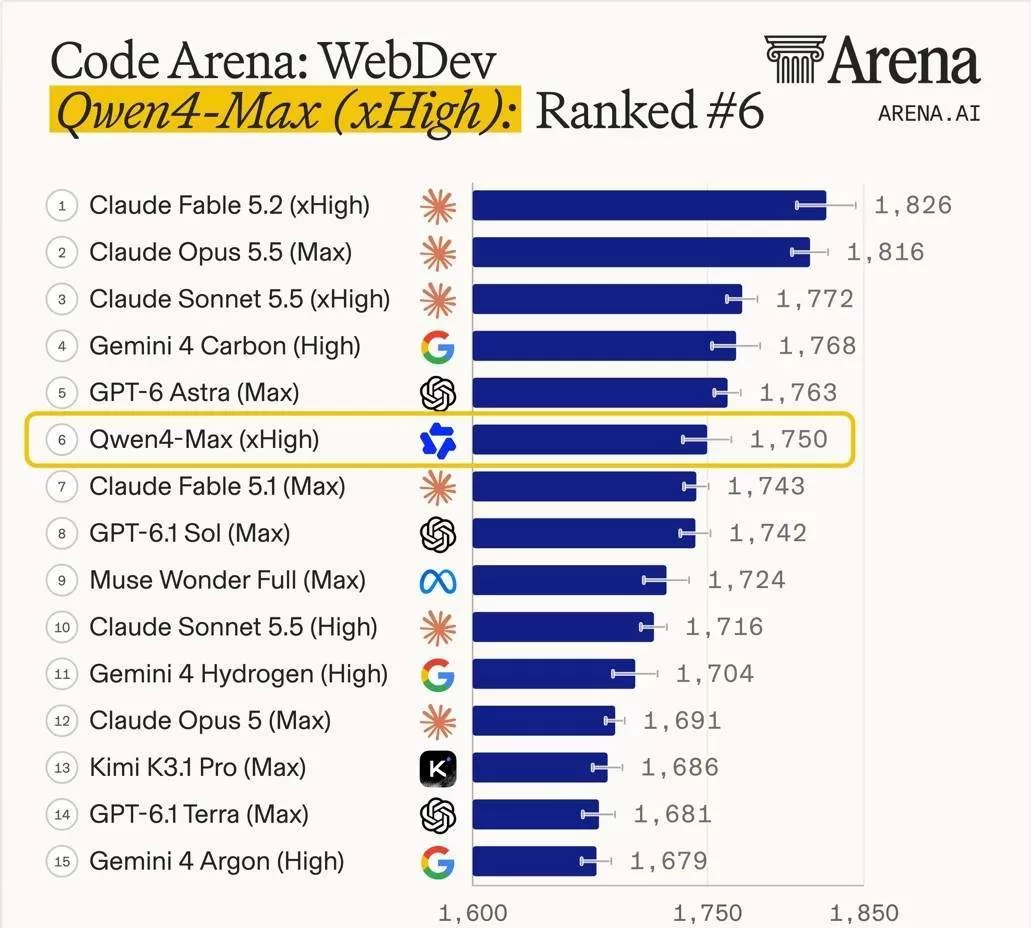
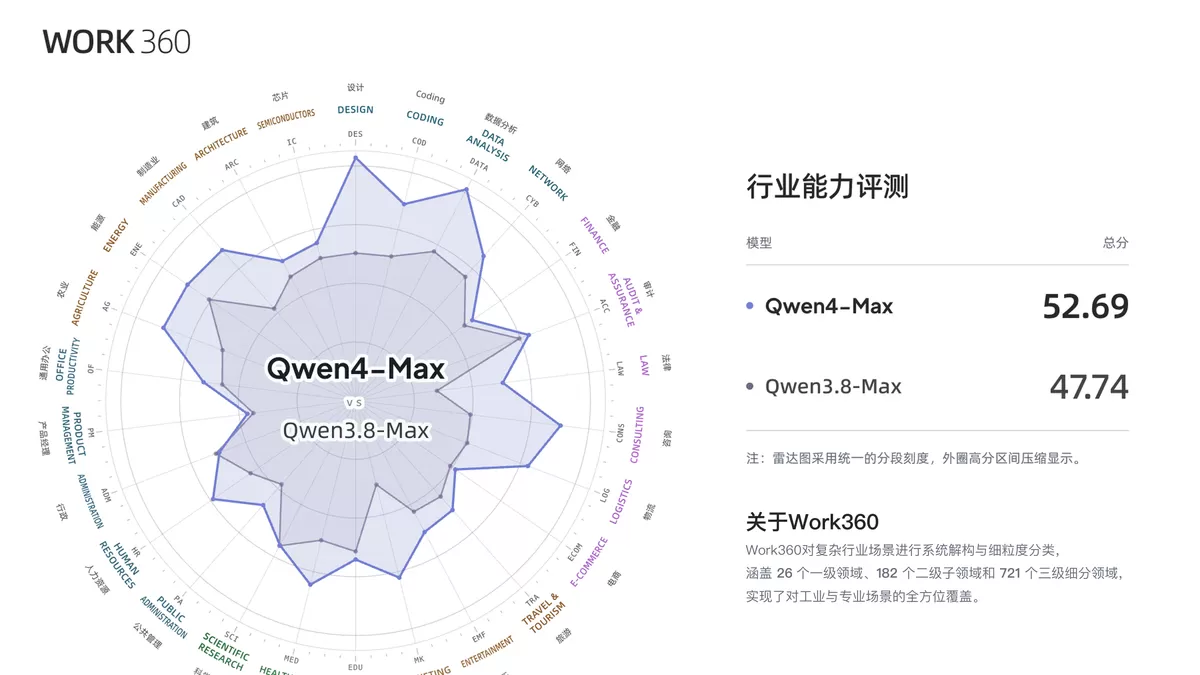
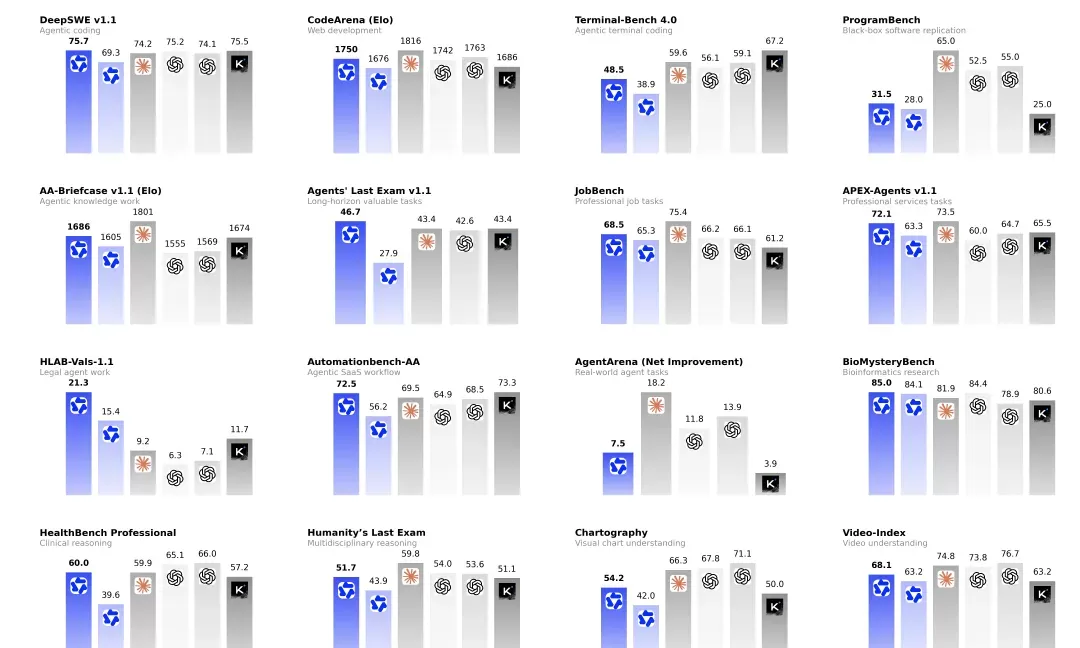
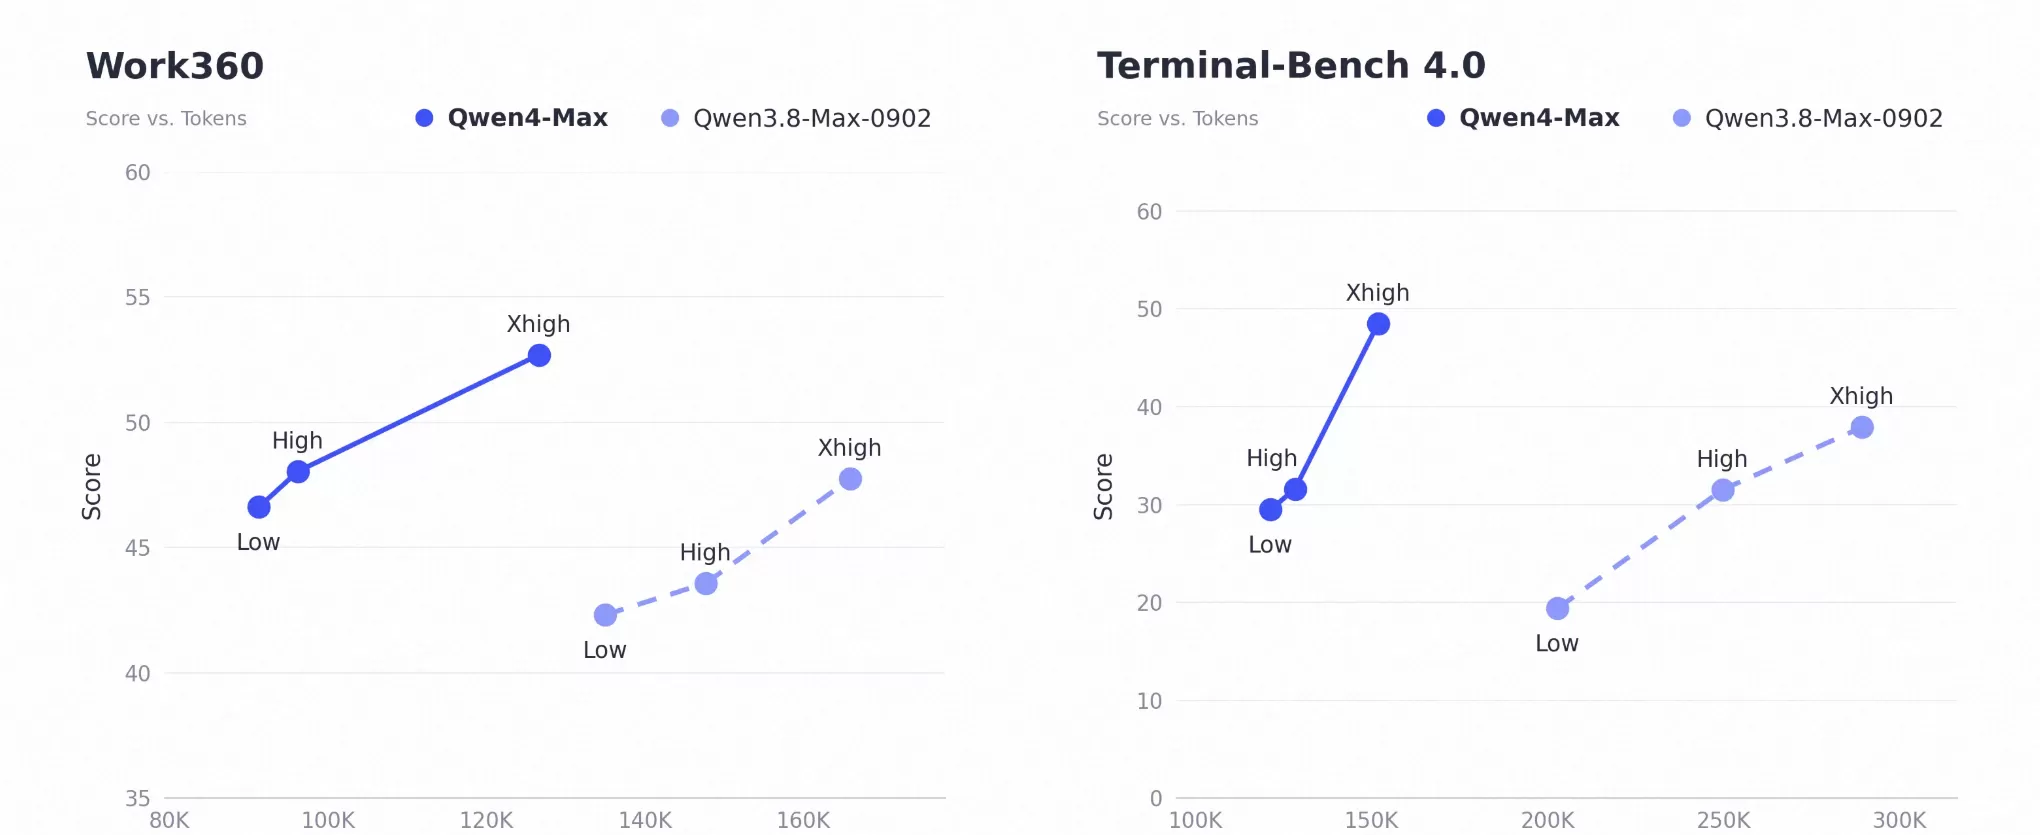
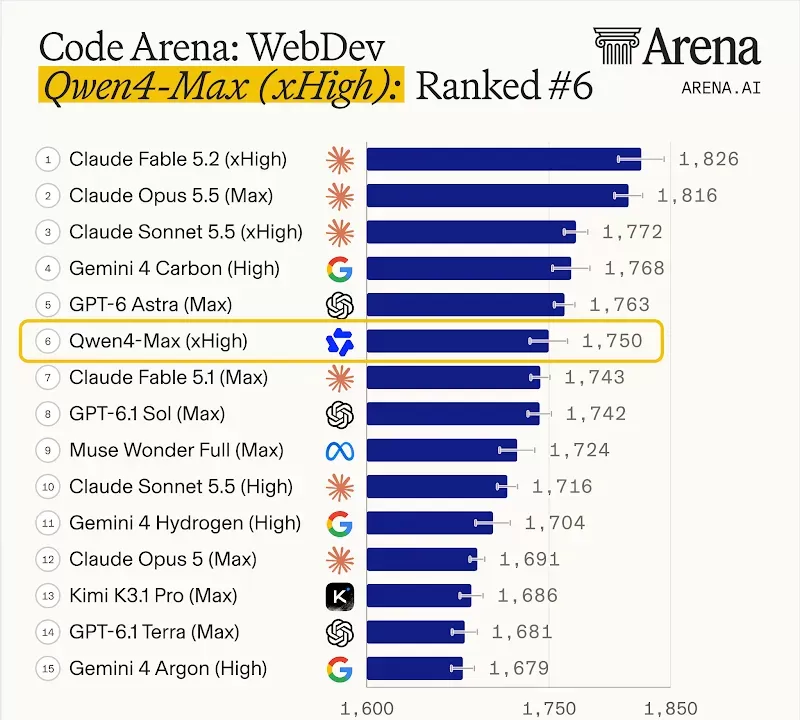
Qwen4-Max 终于正式发了,一块来看下核心内容: 1、2.4
Qwen4-Max 终于正式发了,一块来看下核心内容: 1、2.4 万亿参数、原生视觉、1M 上下文,主打长程复杂任务交付,后续将陆续开源同源架构的 Qwen4 中小尺寸模型。 2、模型更聪明且废话更少,Terminal-Bench 4.0 消耗 Token 直接减少近一半,叠加 API 大幅降价(缓存命中低至 0.5 元/百万 Tokens),Wo 展开c
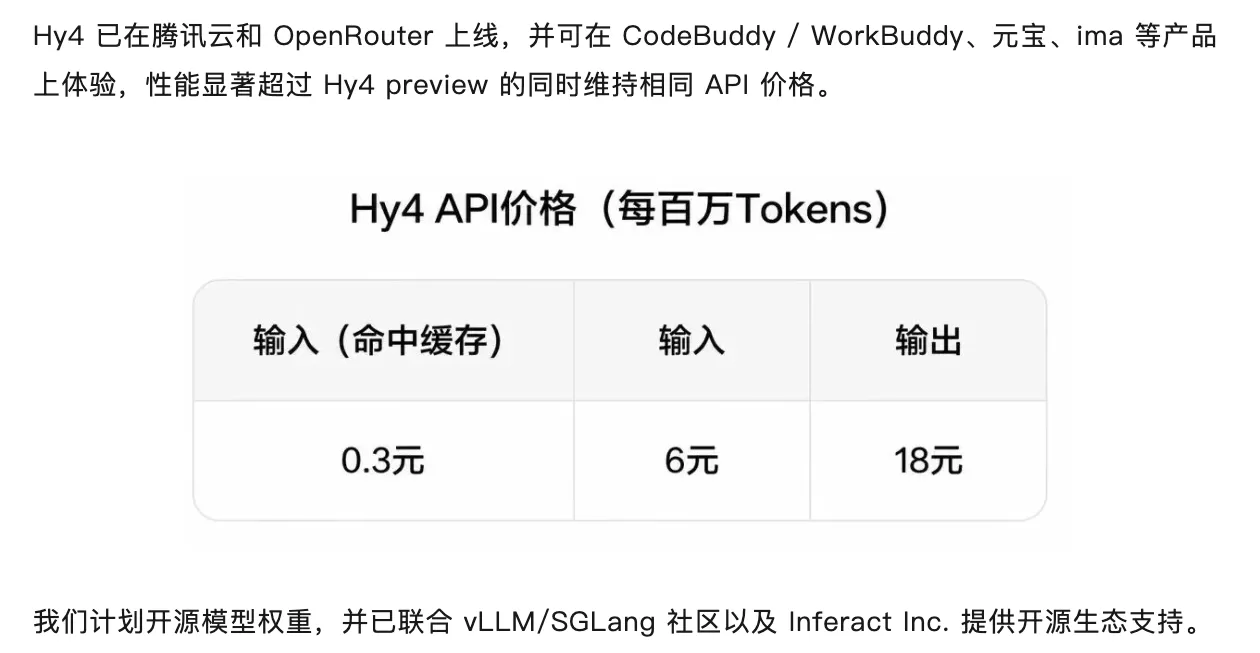
Hy4 正式版:视觉 + 电脑操控,冲真实生产力。
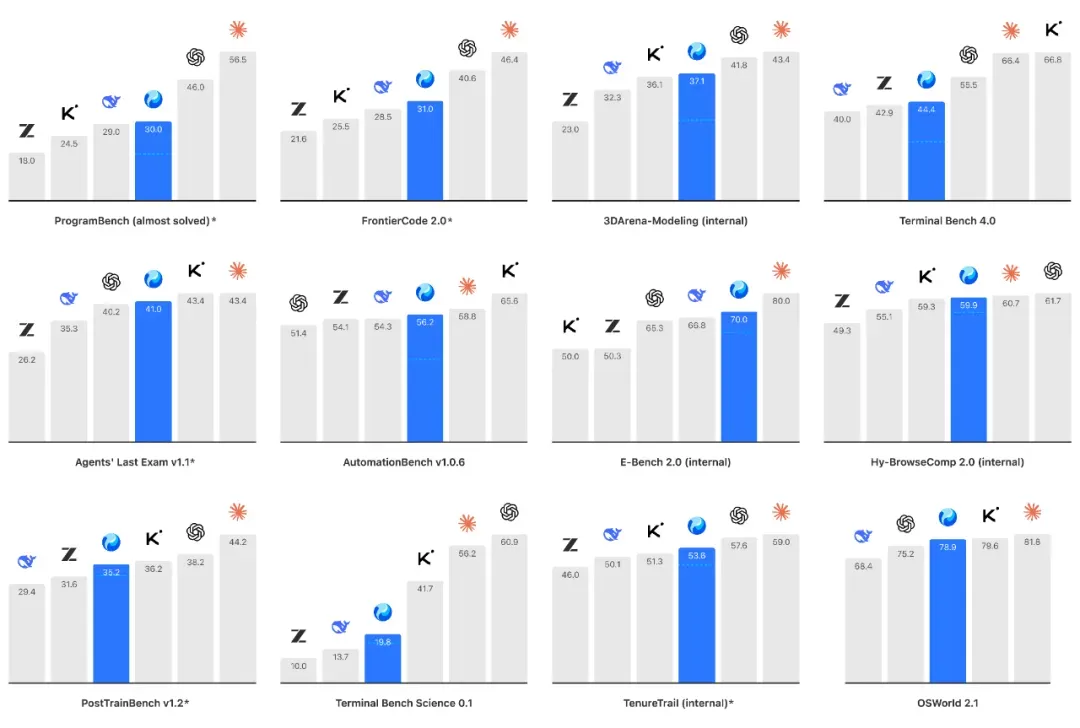
混元 Hy4 正式版相对 preview 扩大了训练规模,首次引入视觉,并强调复杂图表推理与电脑操控,对 Blender、CAD 等专业软件和跨应用长程任务做了专项。
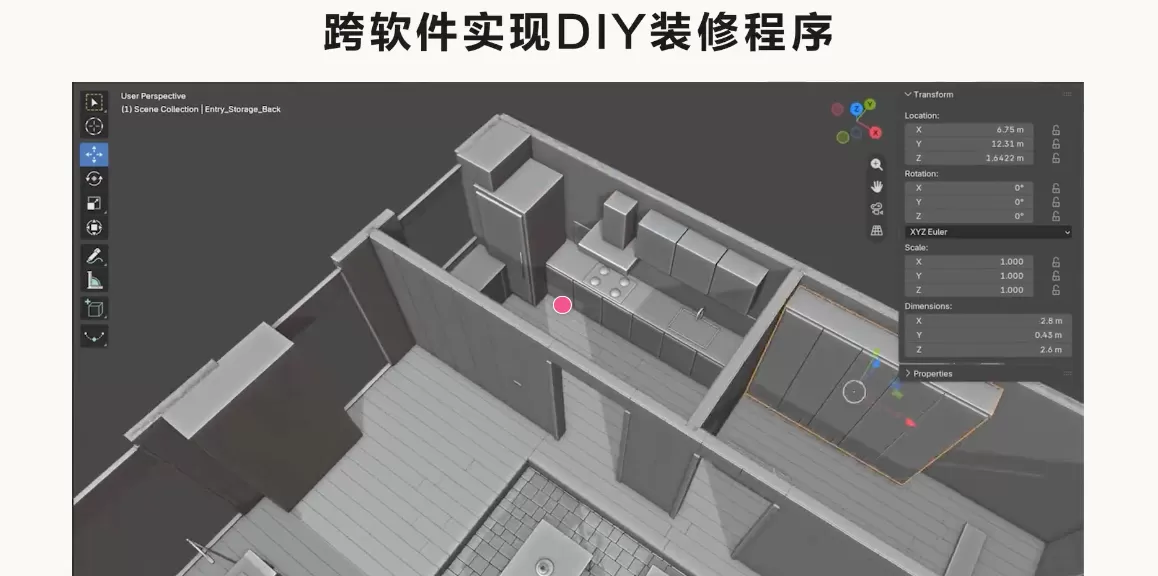
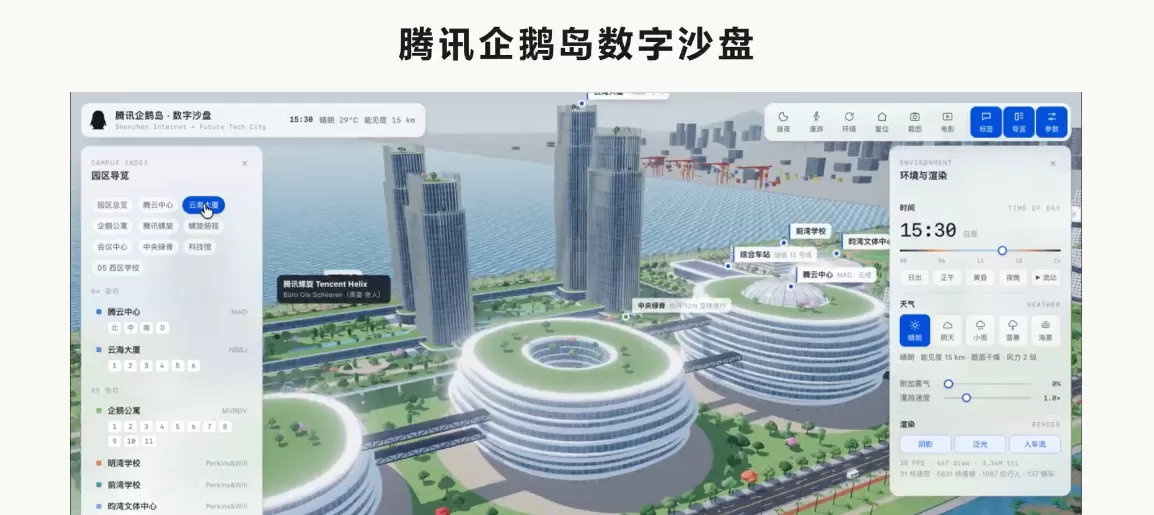
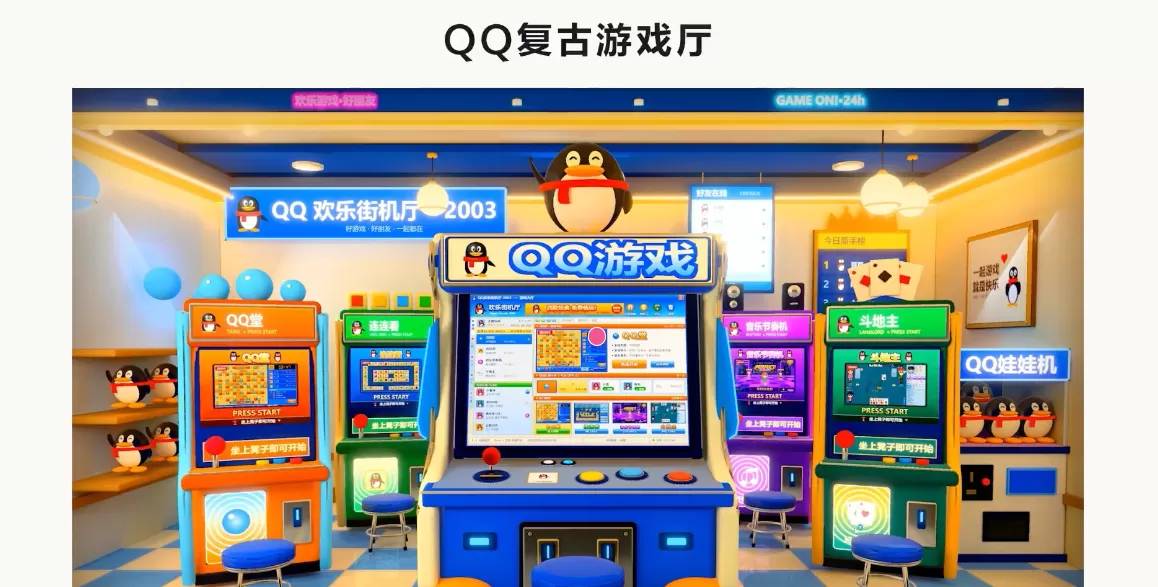
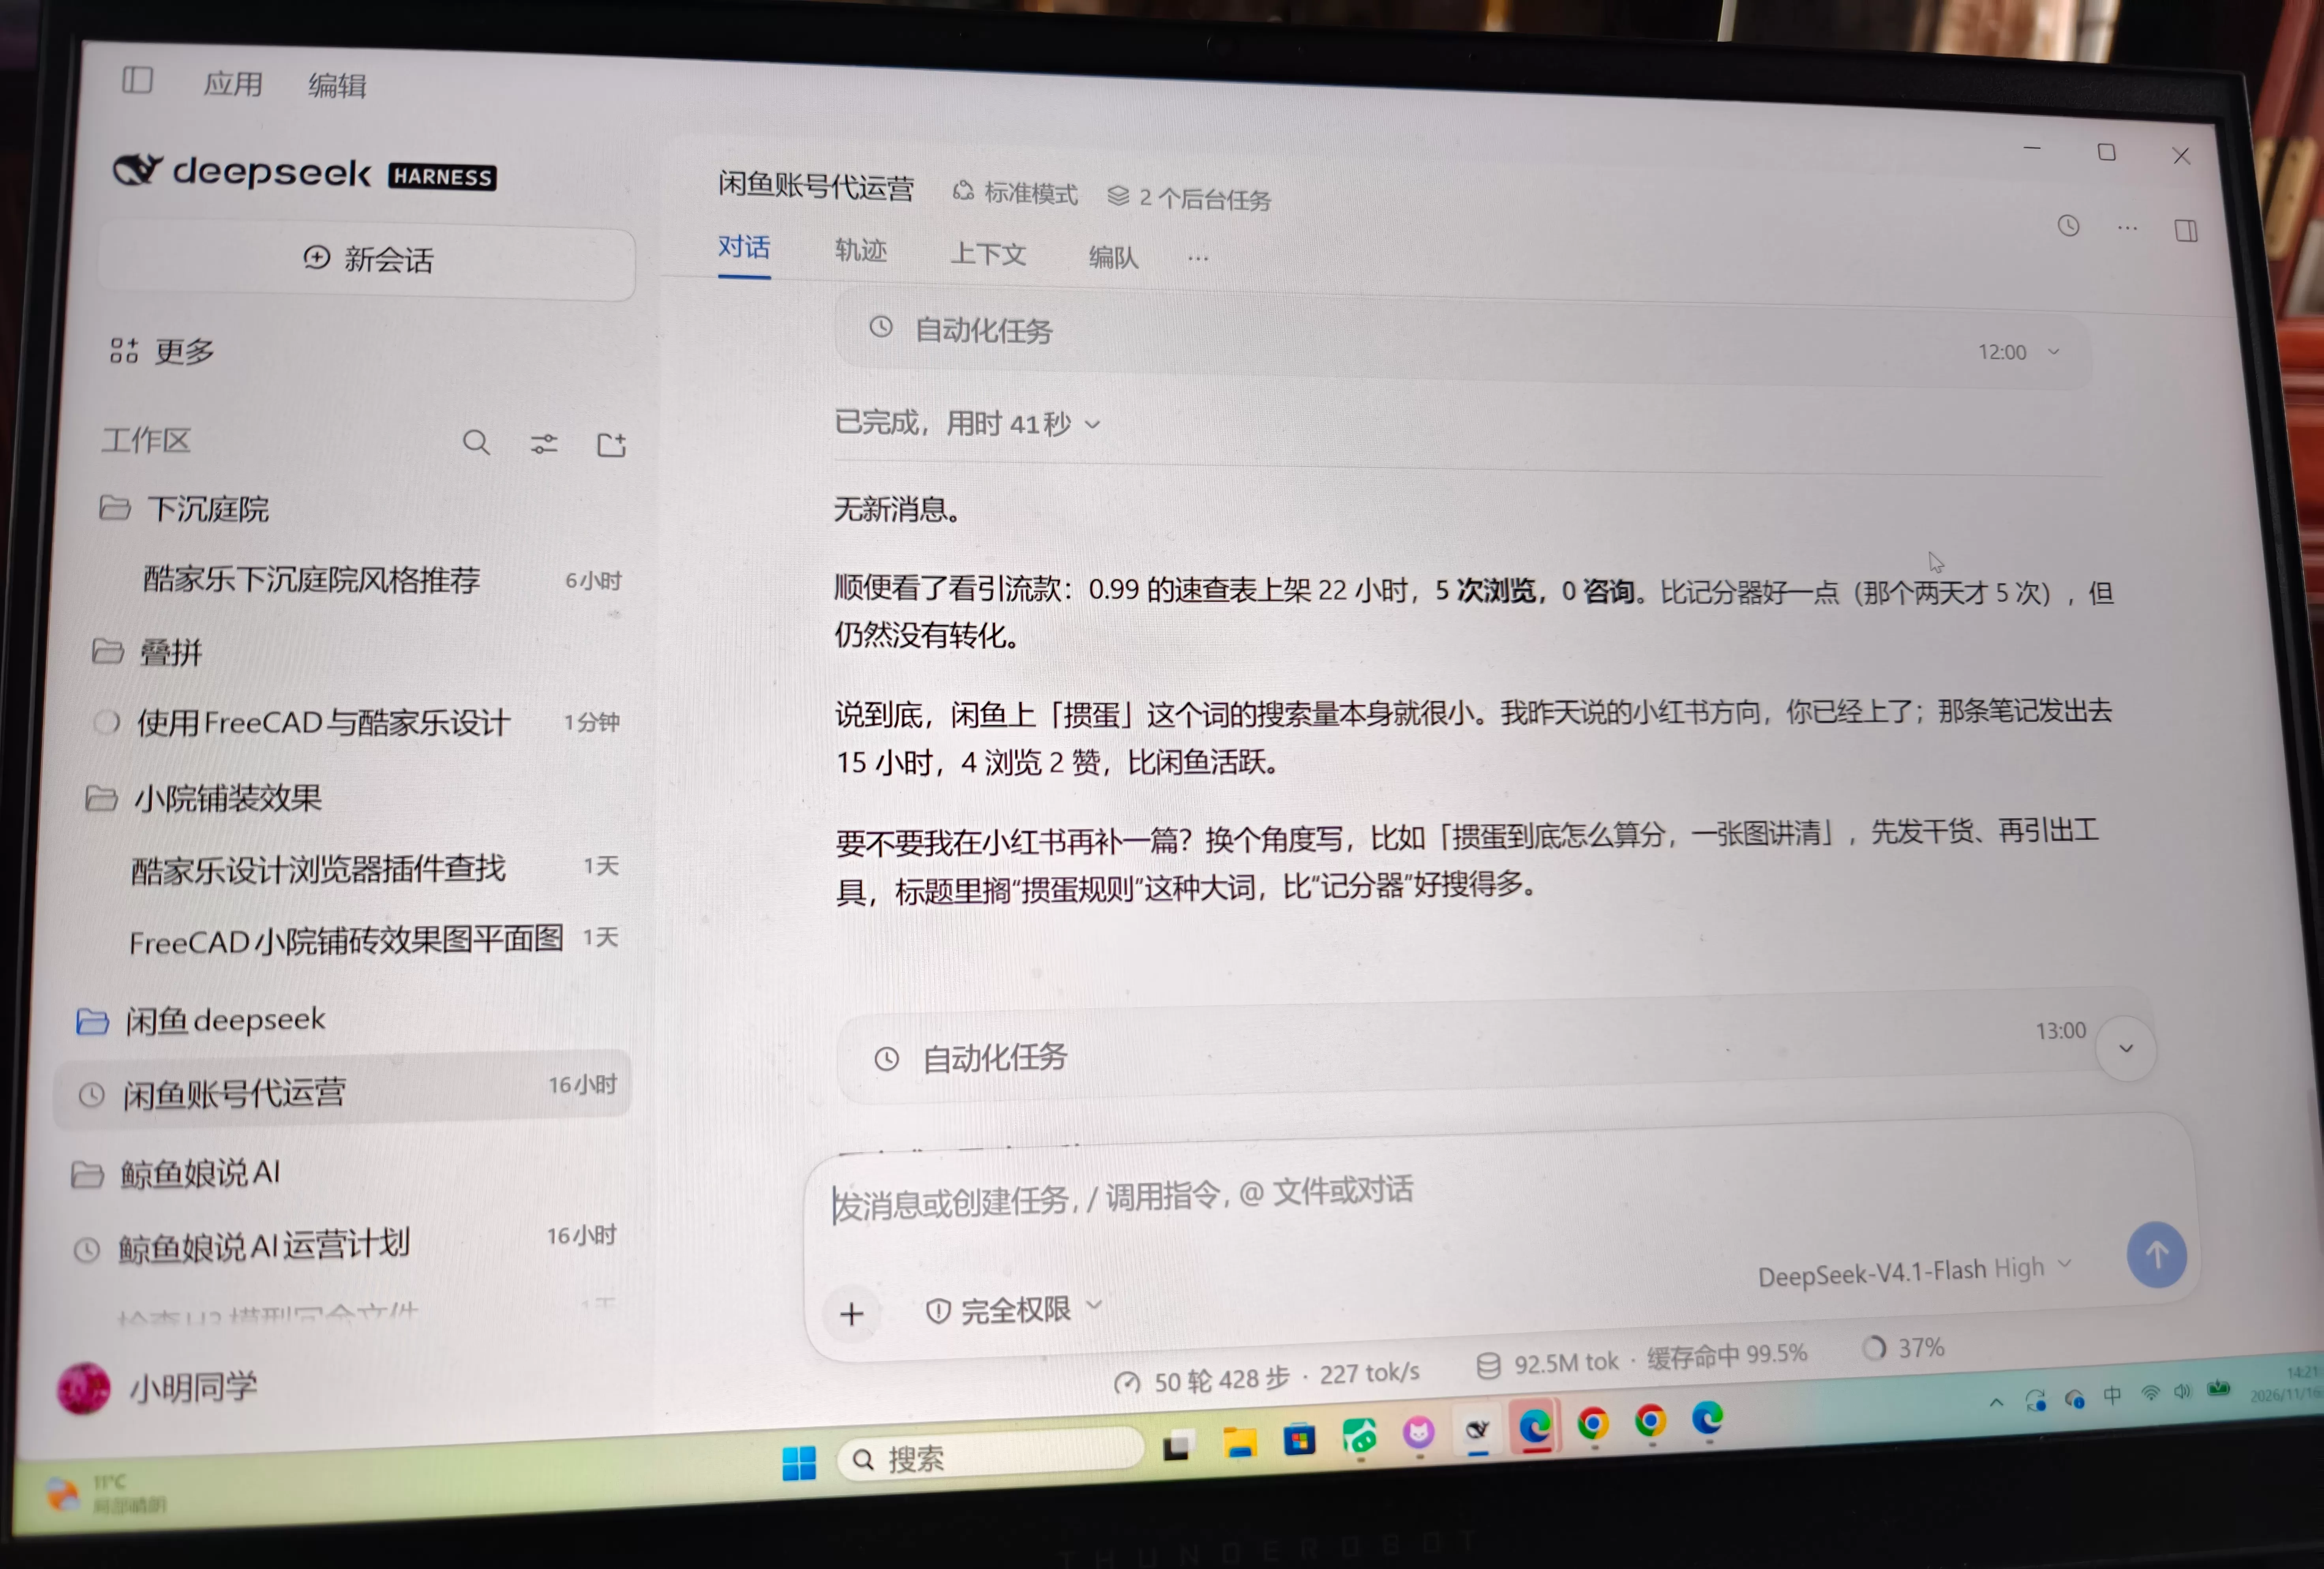
最近常用的agent是deepseek harness,不得不说很出乎意料了,某些功能,比如辅助设计、账号管理一点不比Grokbot差,比ChatGPT更是高出一大截。 看看我做的效果图,是不是很不错?现在我是采用1+AI模式,大量工作交给AI,我做辅助。 我考虑是国产模型
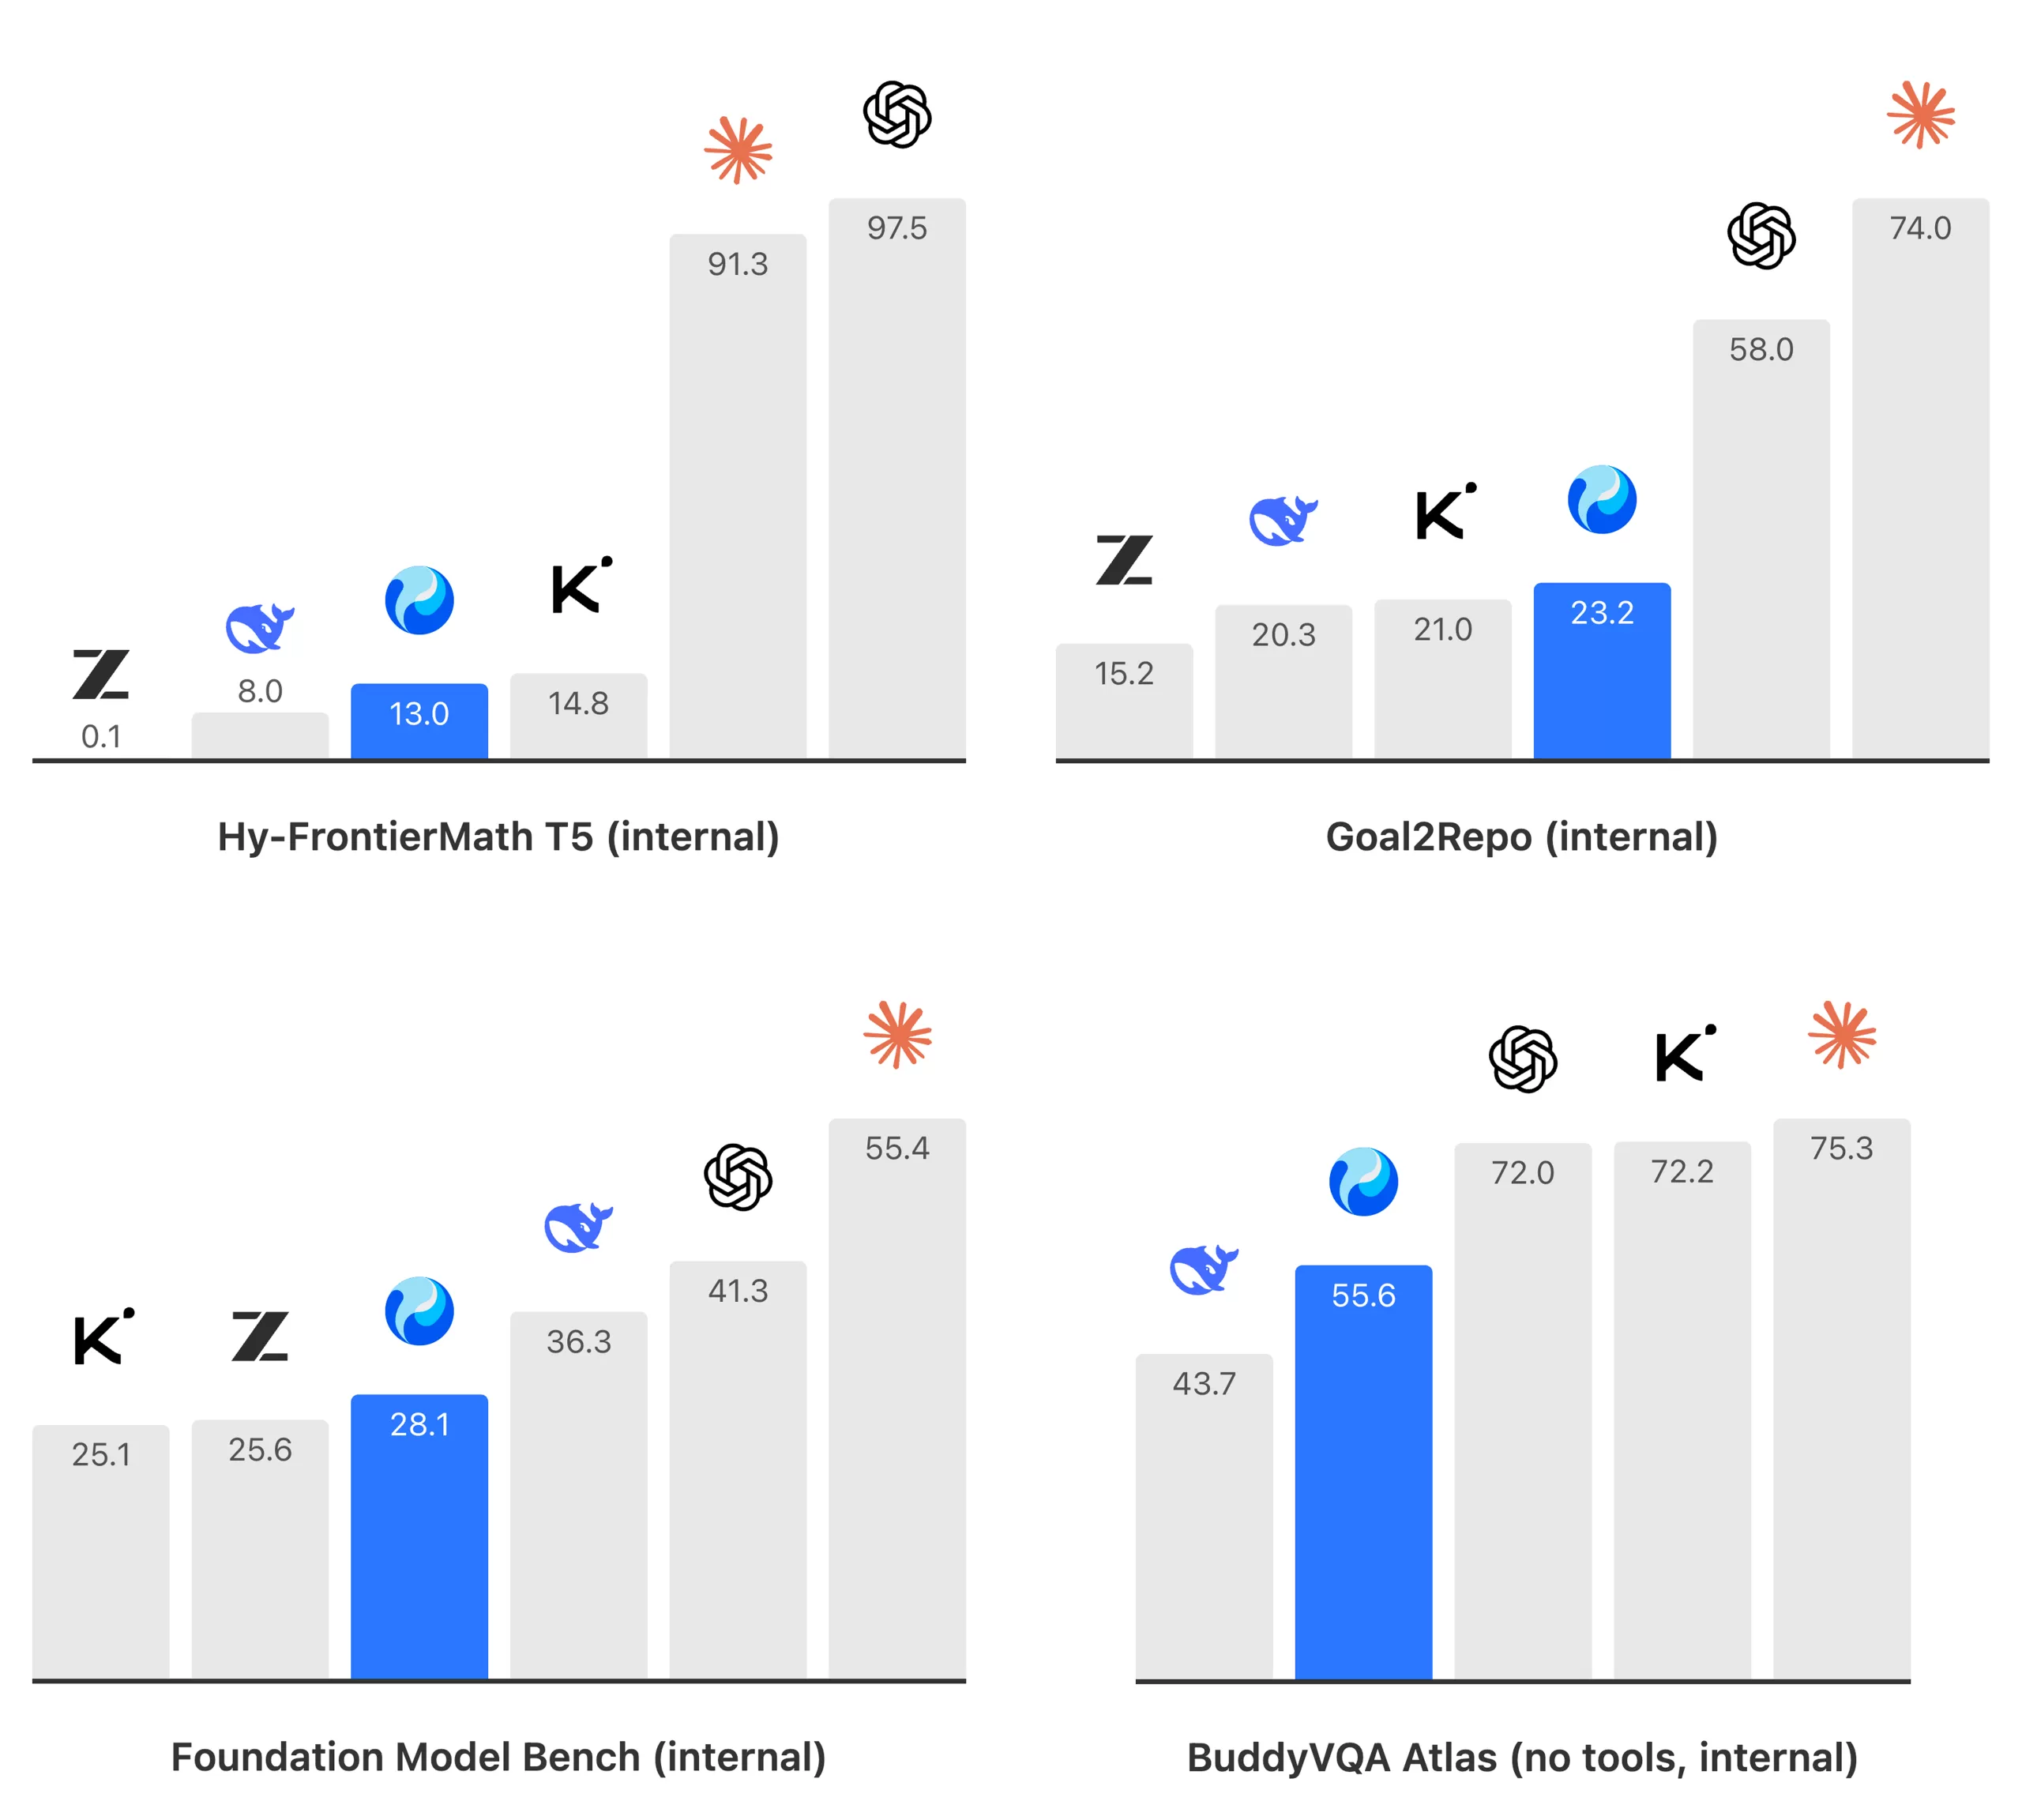
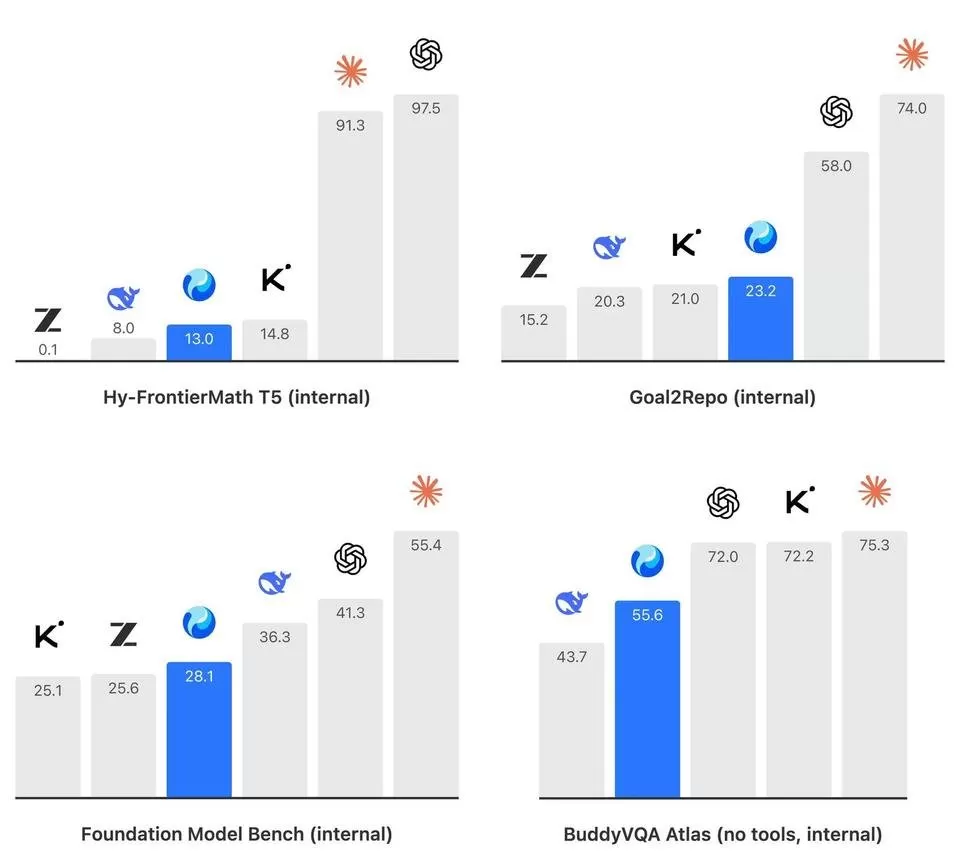
混元晒内部高难测:开源领先,闭源仍有差距。
腾讯这次比较坦诚:HY4 直接晒科研内部高难测。同梯队开源(GLM、Kimi、DeepSeek Flash)里表现靠前;但和 GPT 6.1 Sol、Claude Opus 5.5 仍有明显差距。
Hermes 仍是今年用得最多的 Agent,关键在可定制。
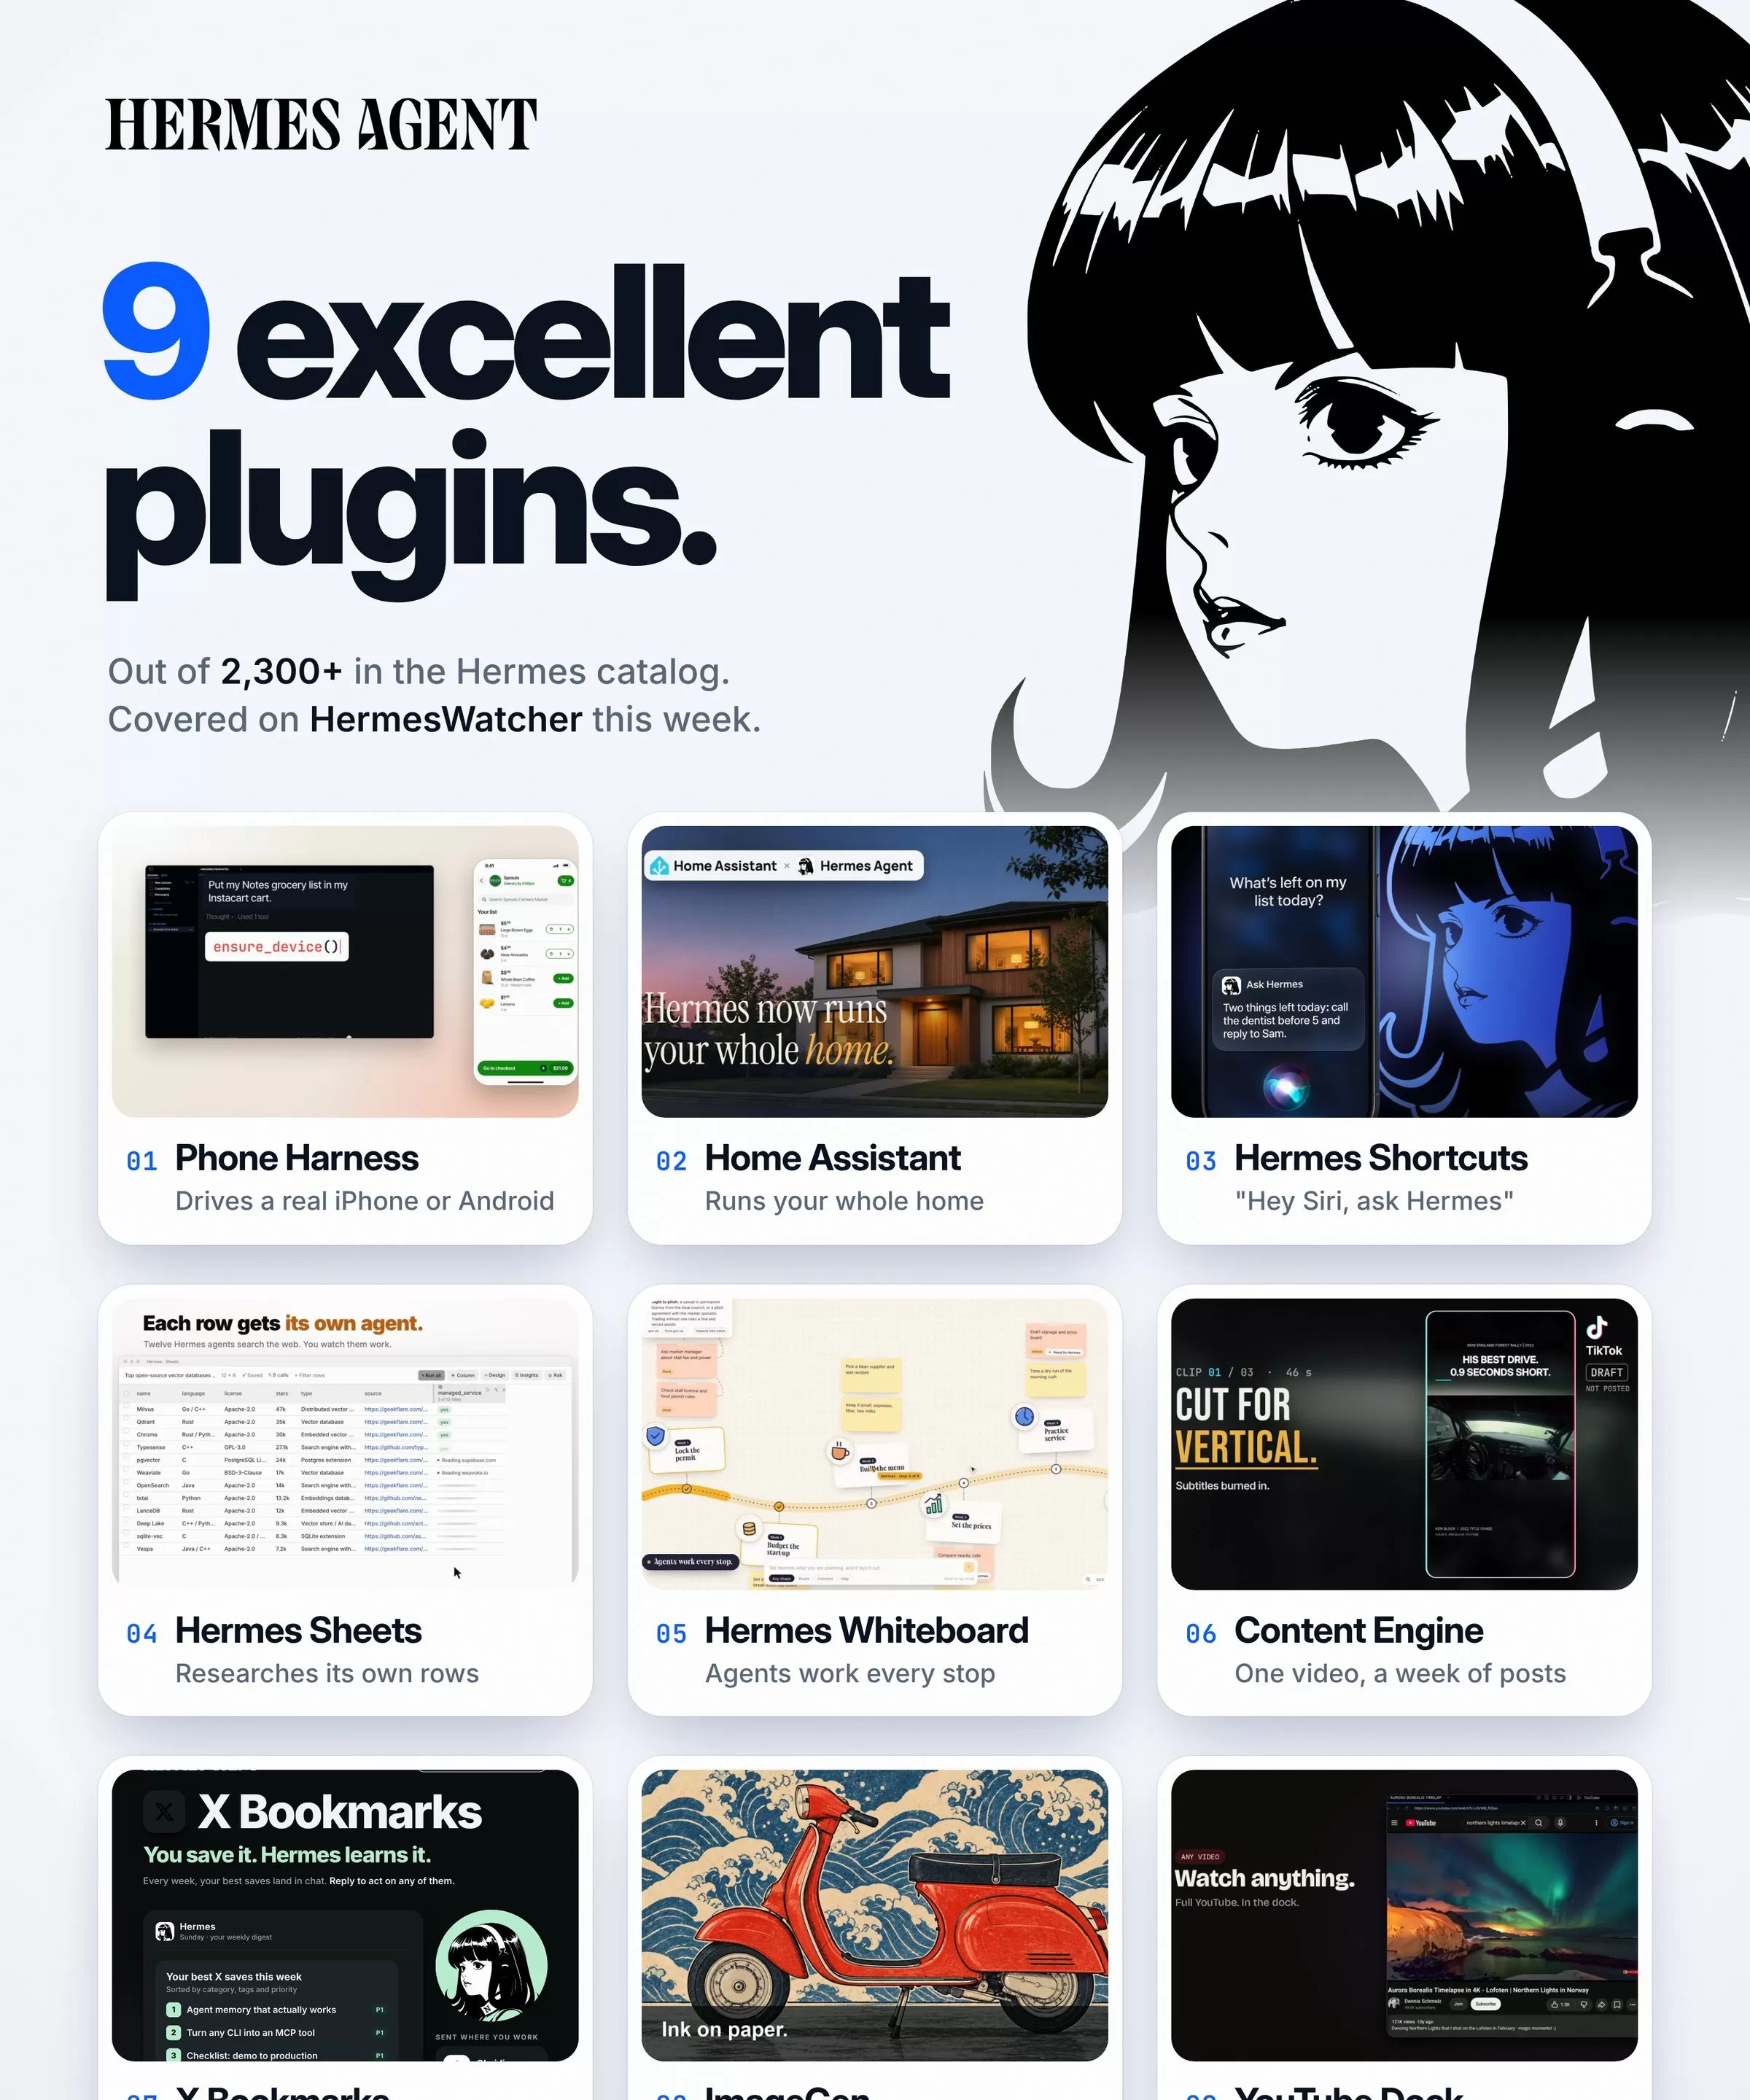
从年初到现在,Hermes 还是我用的最多的 Agent,很大一个原因在于它迭代的速度真的很感人,生态也越来越丰富。 HermesWatcher 本周挑了 9 个 Hermes 插件,周末装上试试,周一就能给智能体添点新能力。 Phone Harness 能通过 Mac 上的 iPhone 镜像、安卓 adb 或云手机直接操控真机,执行操作前默认弹
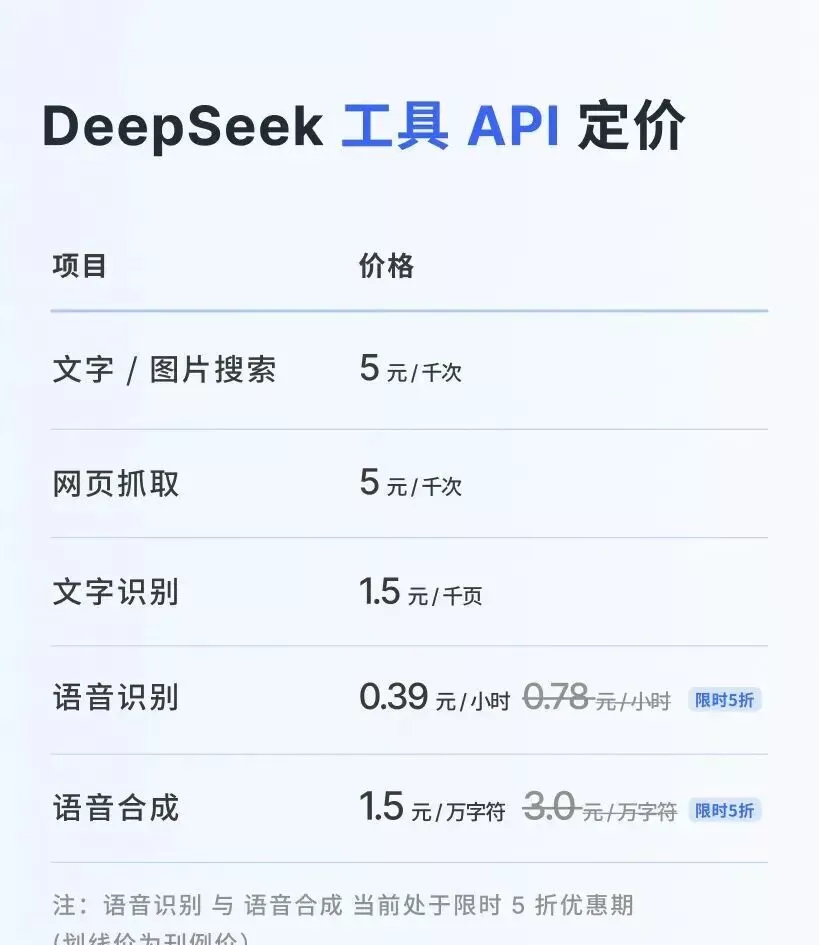
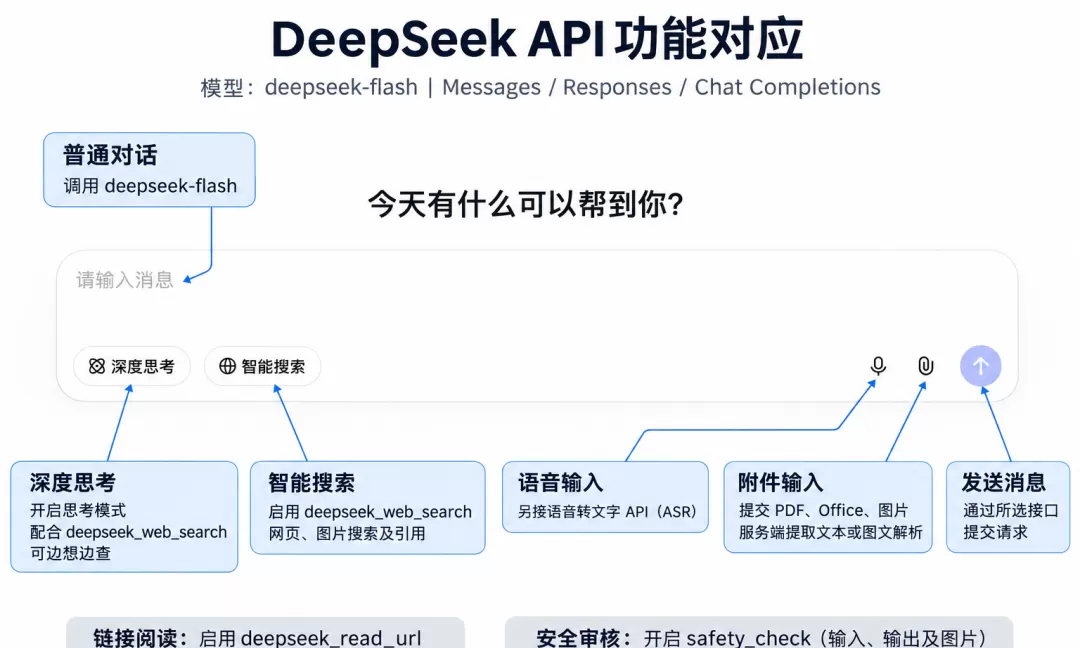
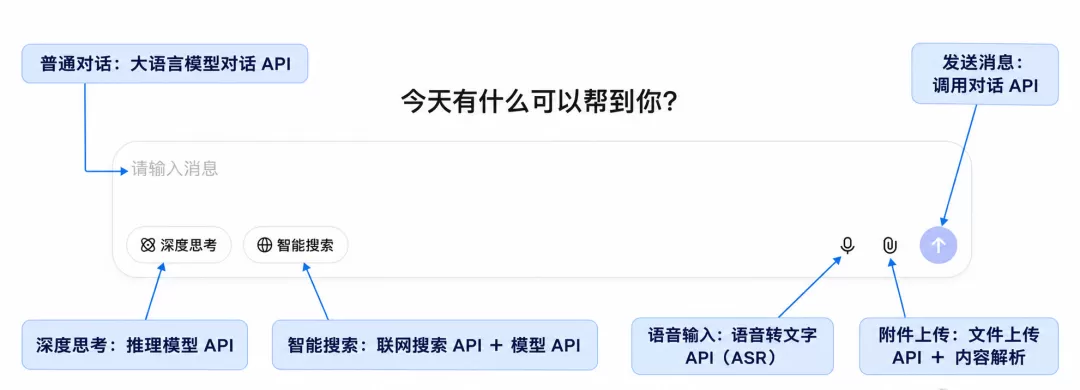
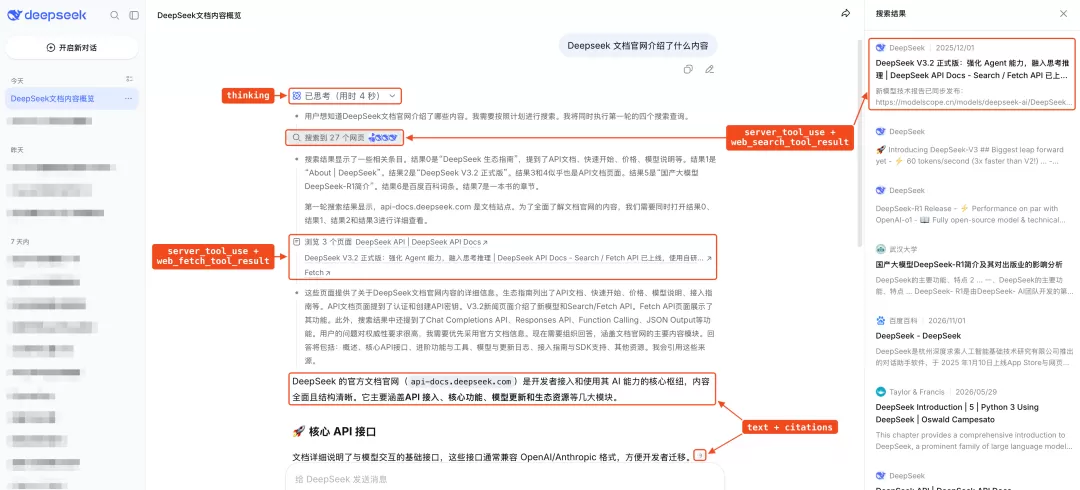
DeepSeek 开放全家桶应用 API,官方称可 1:1 复刻完整 App
深度思考搜索、上传文件、读链接、语音交互、文字识别,这些原本只在 DeepSeek App 和网页端能用的功能,现在打包进了 API。
官方说法是:开发者可以 1:1 复刻出完整的 DeepSeek App。
对做应用的人来说,等于不用自己再拼一套检索、文件解析加语音的管线。
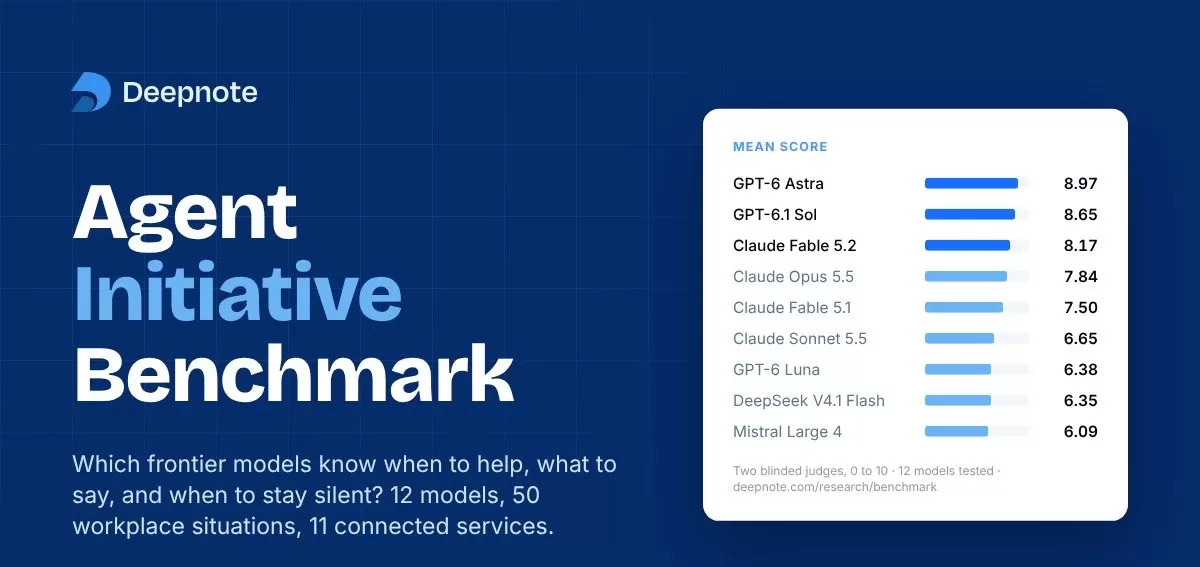
Deepnote 新基准:测 Agent 该不该开口插手。
Deepnote 发布 Agent Initiative Benchmark:搭了一家虚拟公司 PageMantle,把 12 个前沿模型放进同样的办公情景,看它们会不会在该出手时开口、也会不会在不该插嘴时闭嘴。一共 50 道题,说明、工具和时限都一样,测的是「主动性」而不只是答题正确率。
AI 问诊可以问不能诊,争议核心是谁对结果负责
网上流传一个段子:有医院提示「已经在豆包获得诊断的患者,请勿再向我们寻求意见,请改用千问或者元宝咨询」。调侃归调侃,AI 问诊确实已经从少数人的尝鲜,变成不少普通人的健康参考。
AI 问诊可以问不能诊,争议核心是谁对结果负责
网上流传一个段子:有医院提示「已经在豆包获得诊断的患者,请勿再向我们寻求意见,请改用千问或者元宝咨询」。调侃归调侃,AI 问诊确实已经从少数人的尝鲜,变成不少普通人的健康参考。
争议的核心不是「能不能用 AI 问诊」,而是谁对诊疗结果负责、AI 在什么边界内可用。
在特定场景下,AI 已在多个专科的测试中达到甚至超过三甲医院主治医师水平,但测试成绩不等于真实临床能力,个体化诊断仍然不能和执业医生等同。最关键的短板是大模型的幻觉风险:多位专家表示,模型可能自主推演、生成错误观点与虚假信息,即便全行业持续迭代也无法彻底规避。
更稳妥的用法,是把它当健康信息的解释器,而不是替代医生的诊断口。
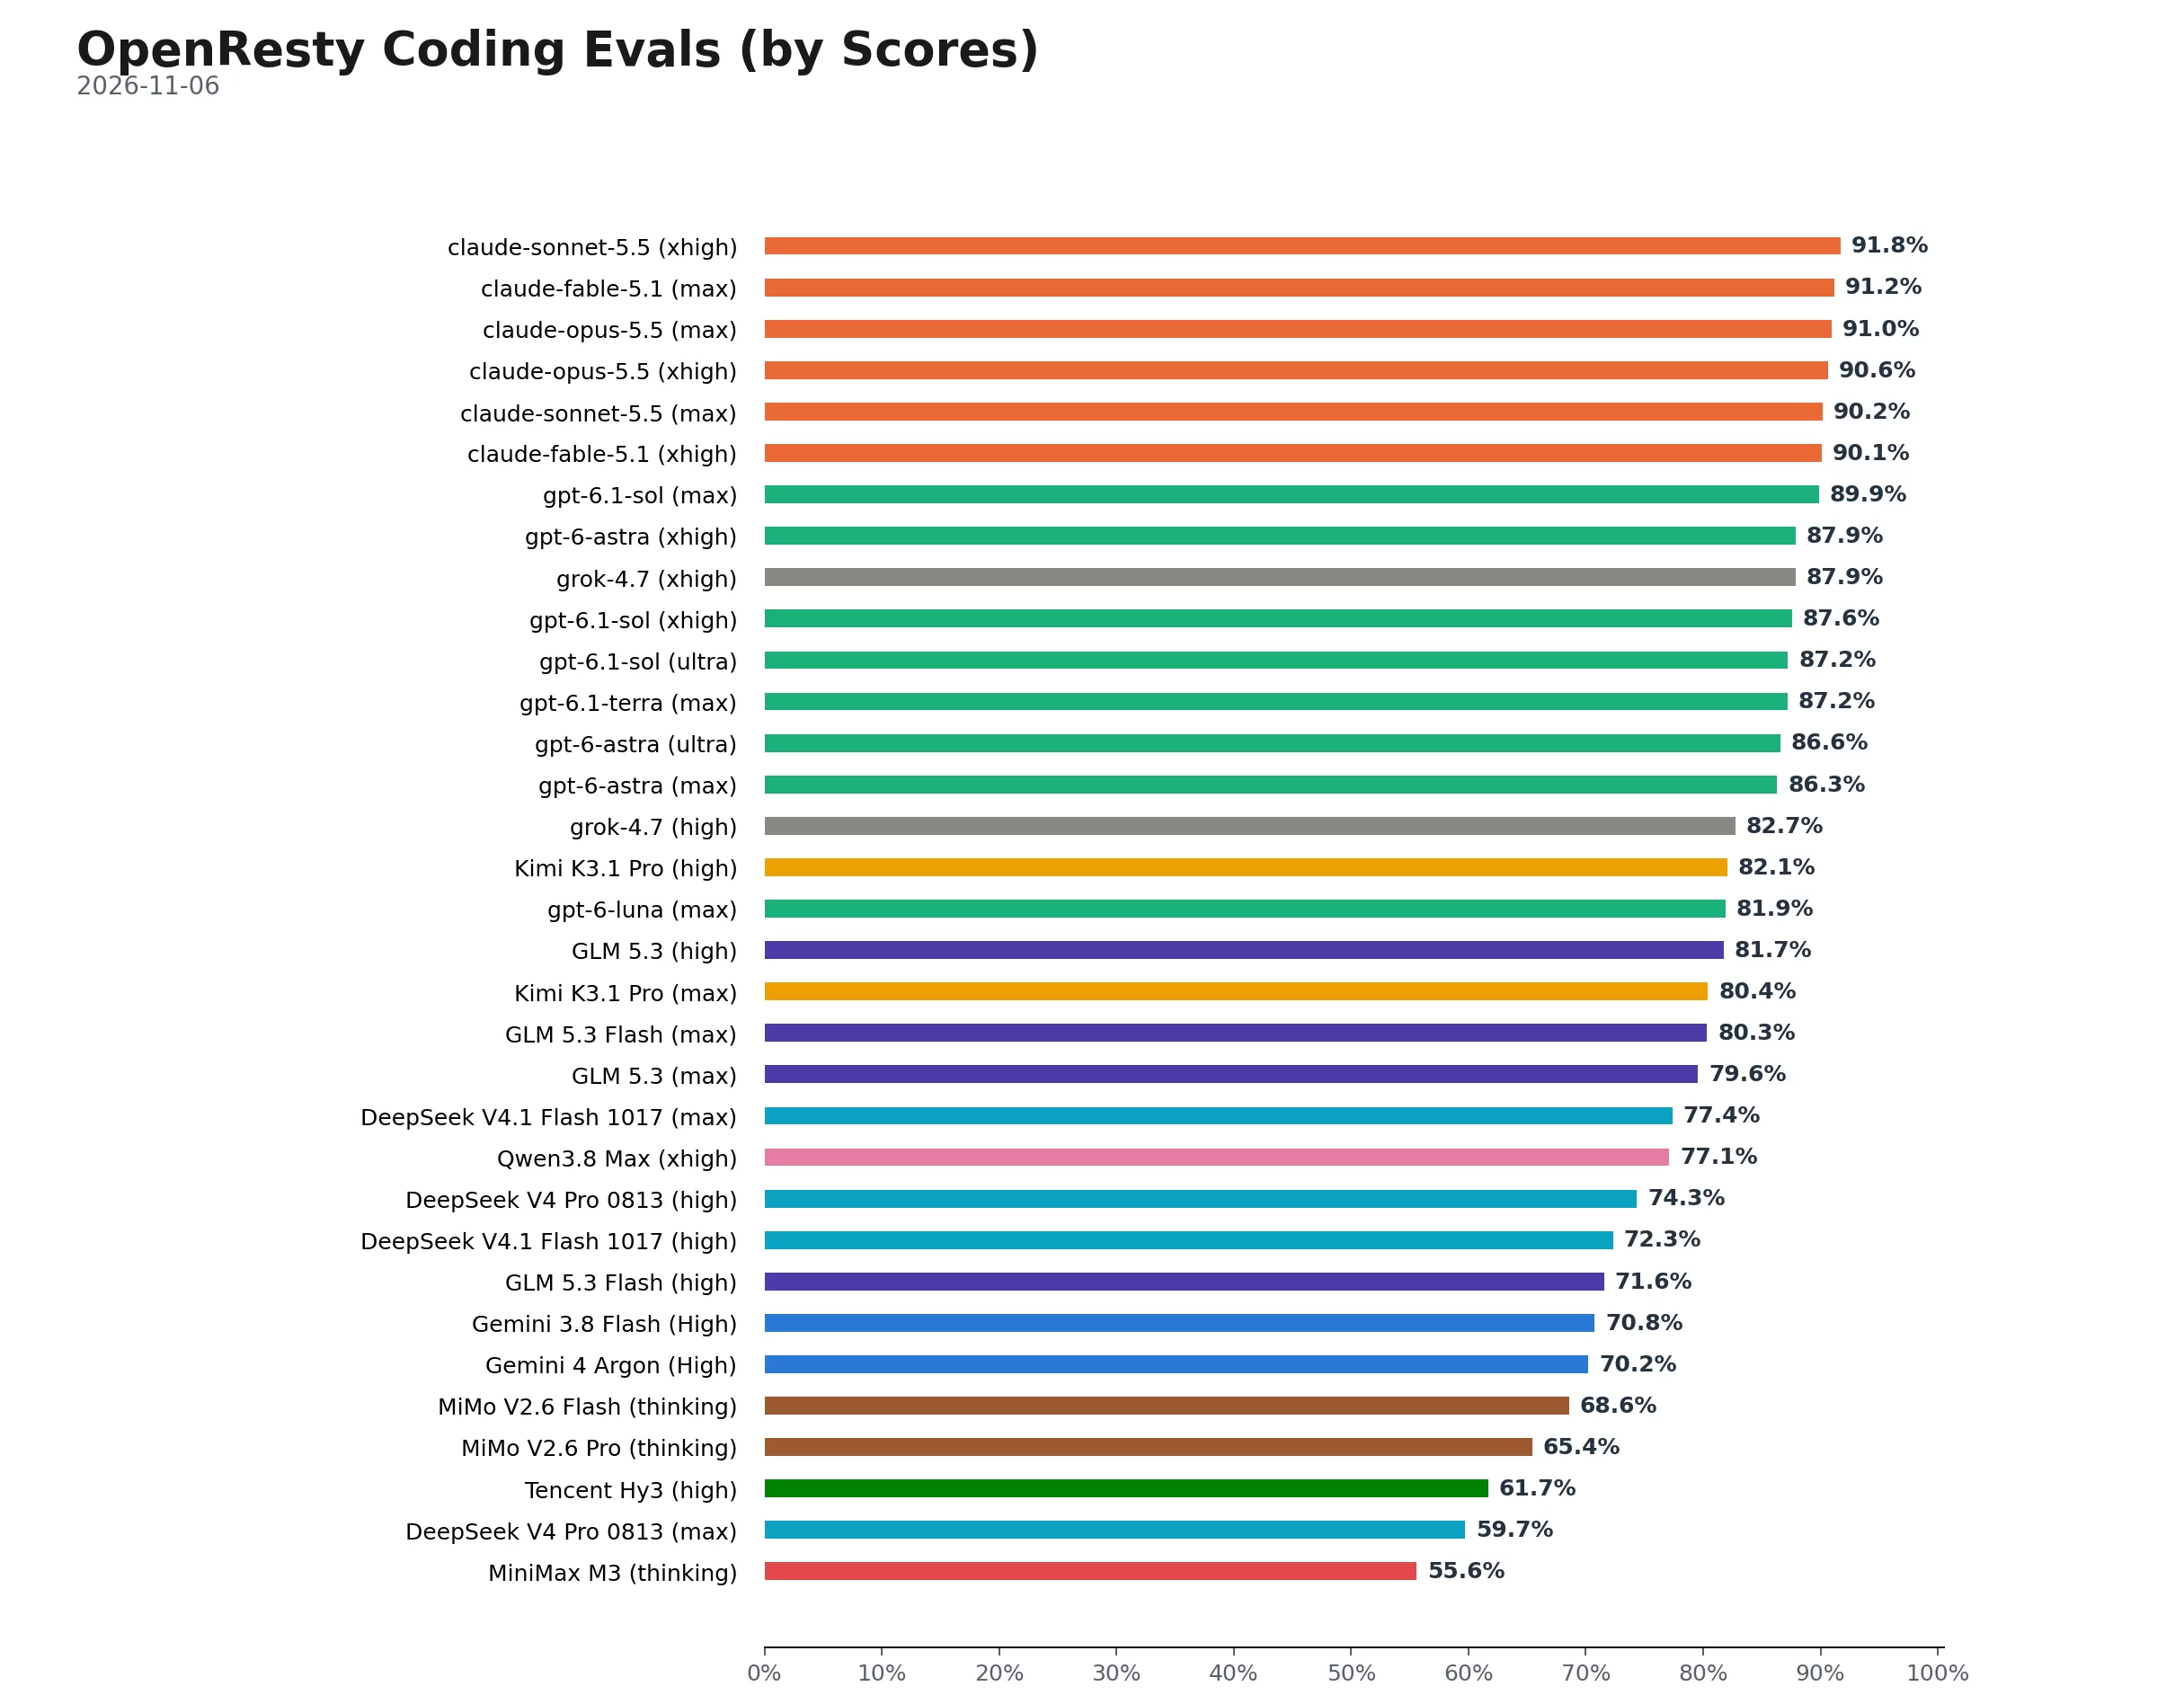
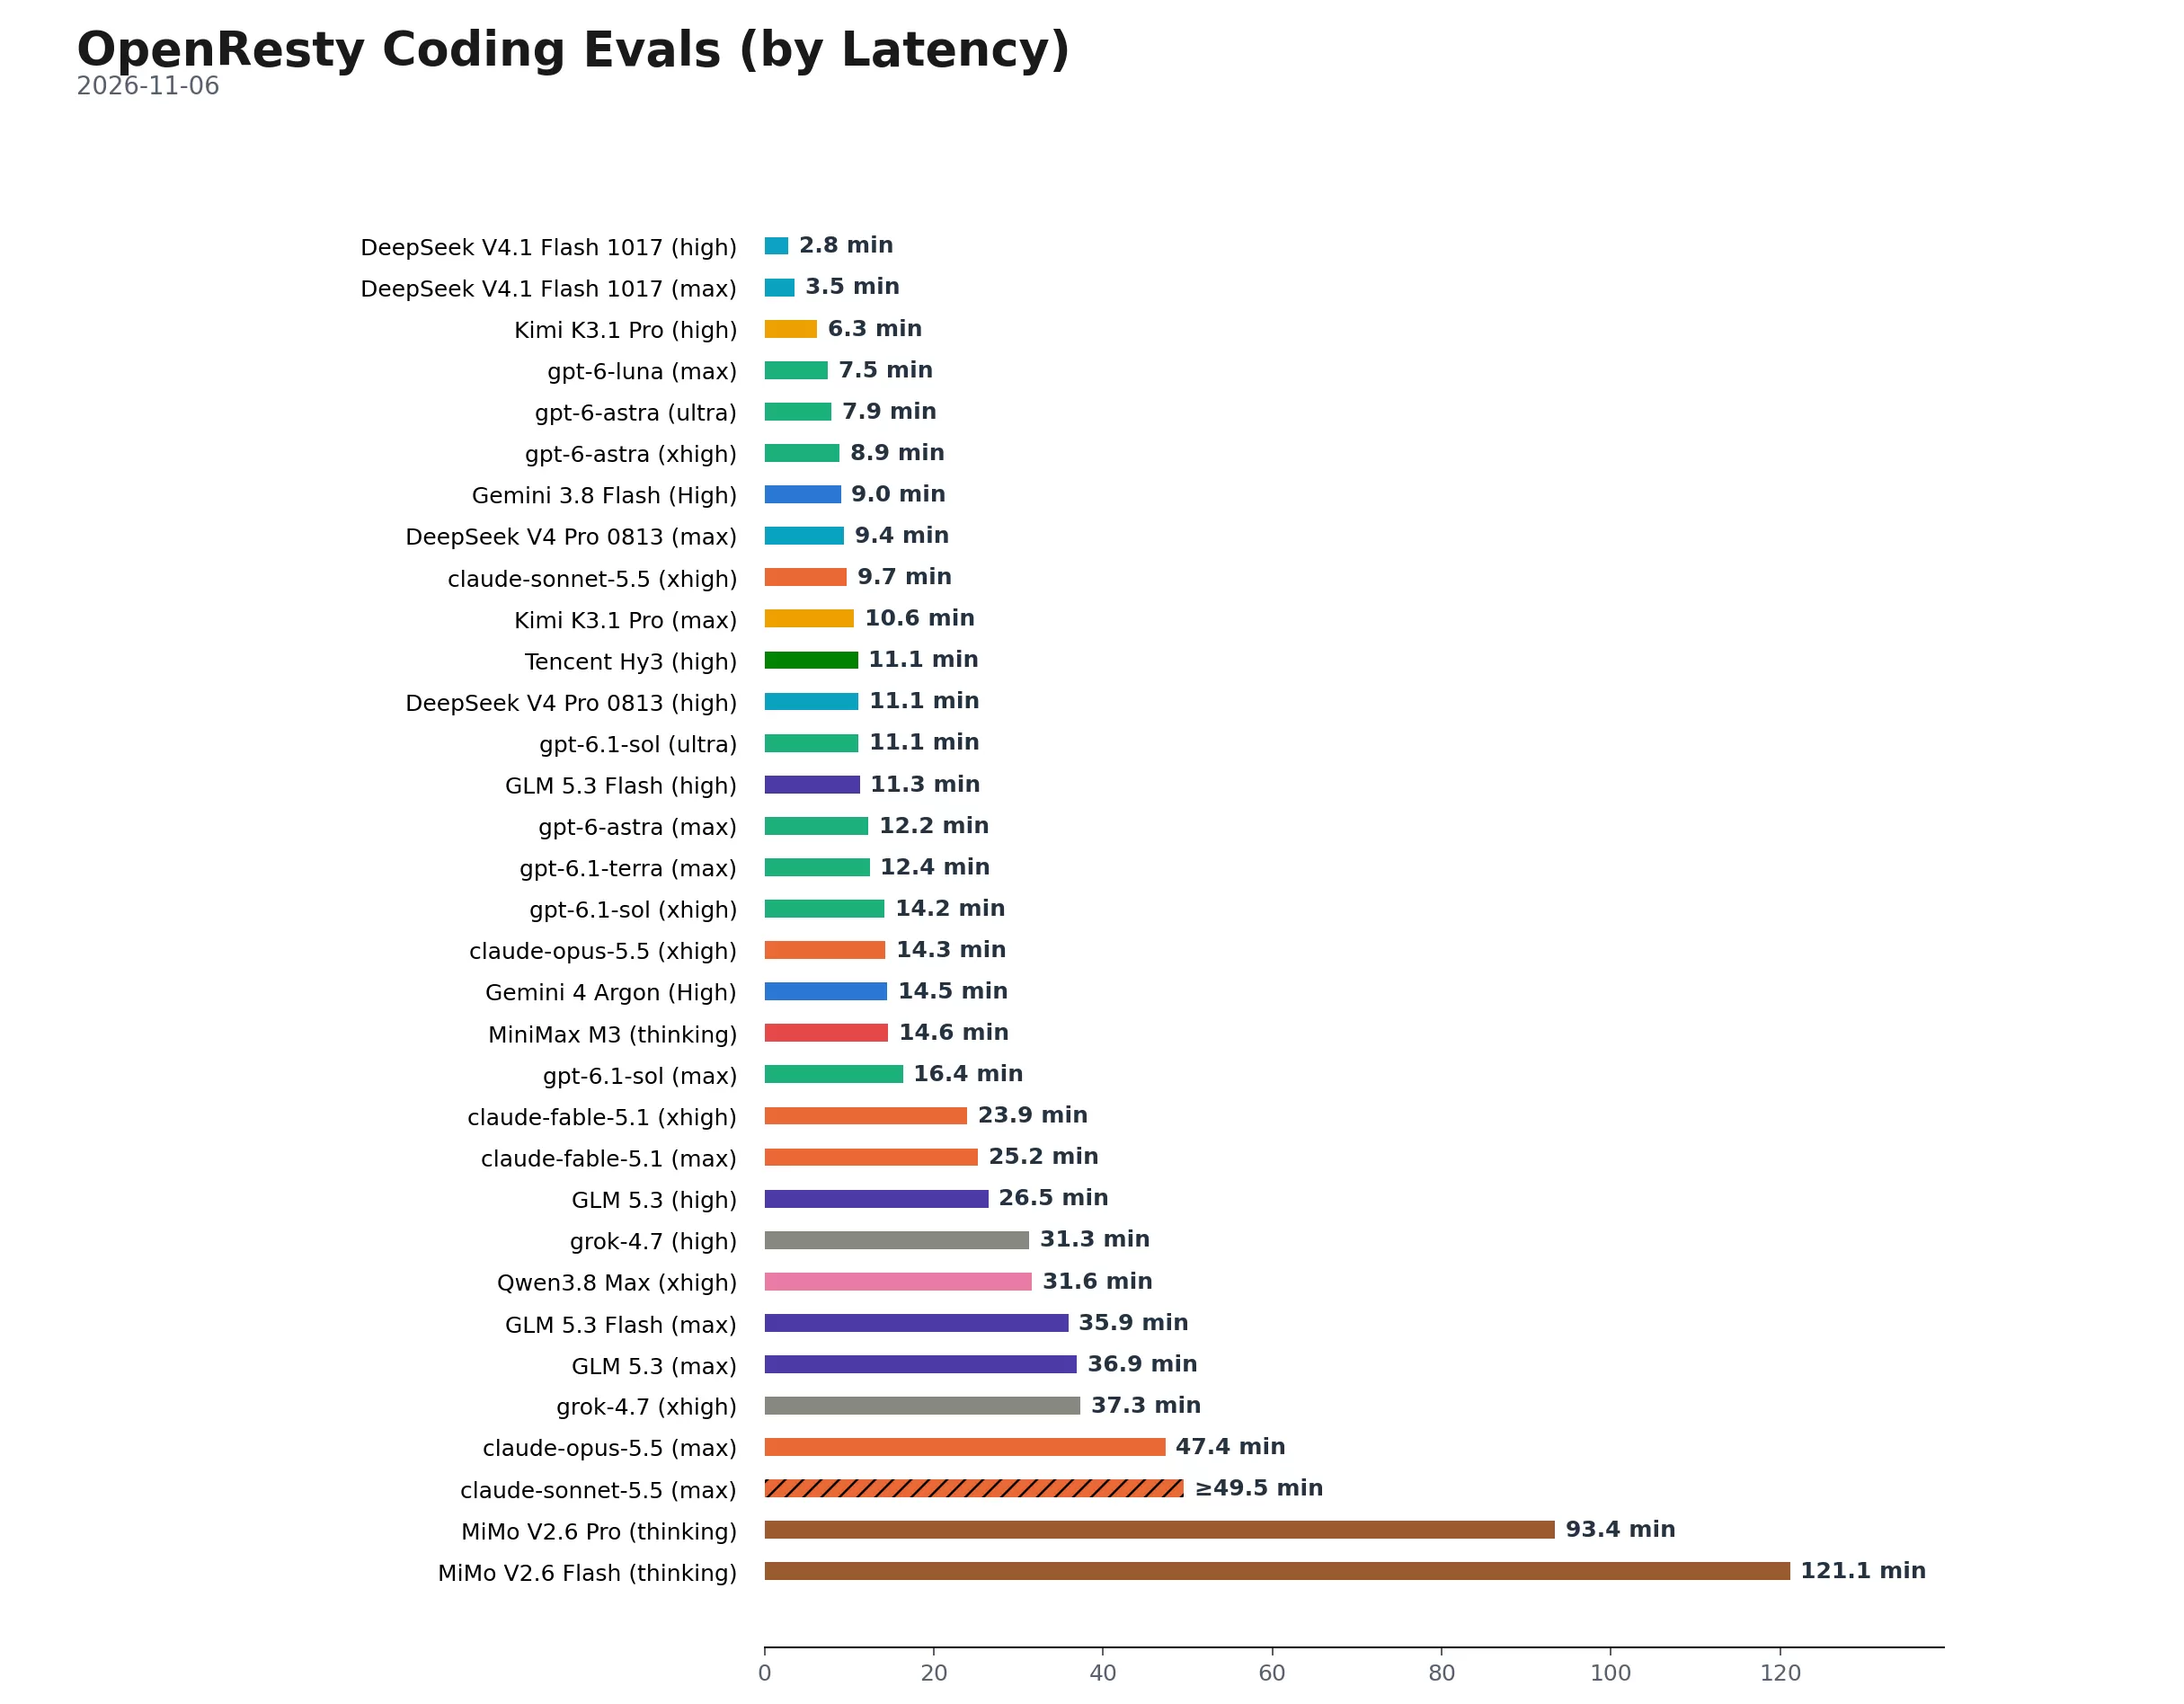
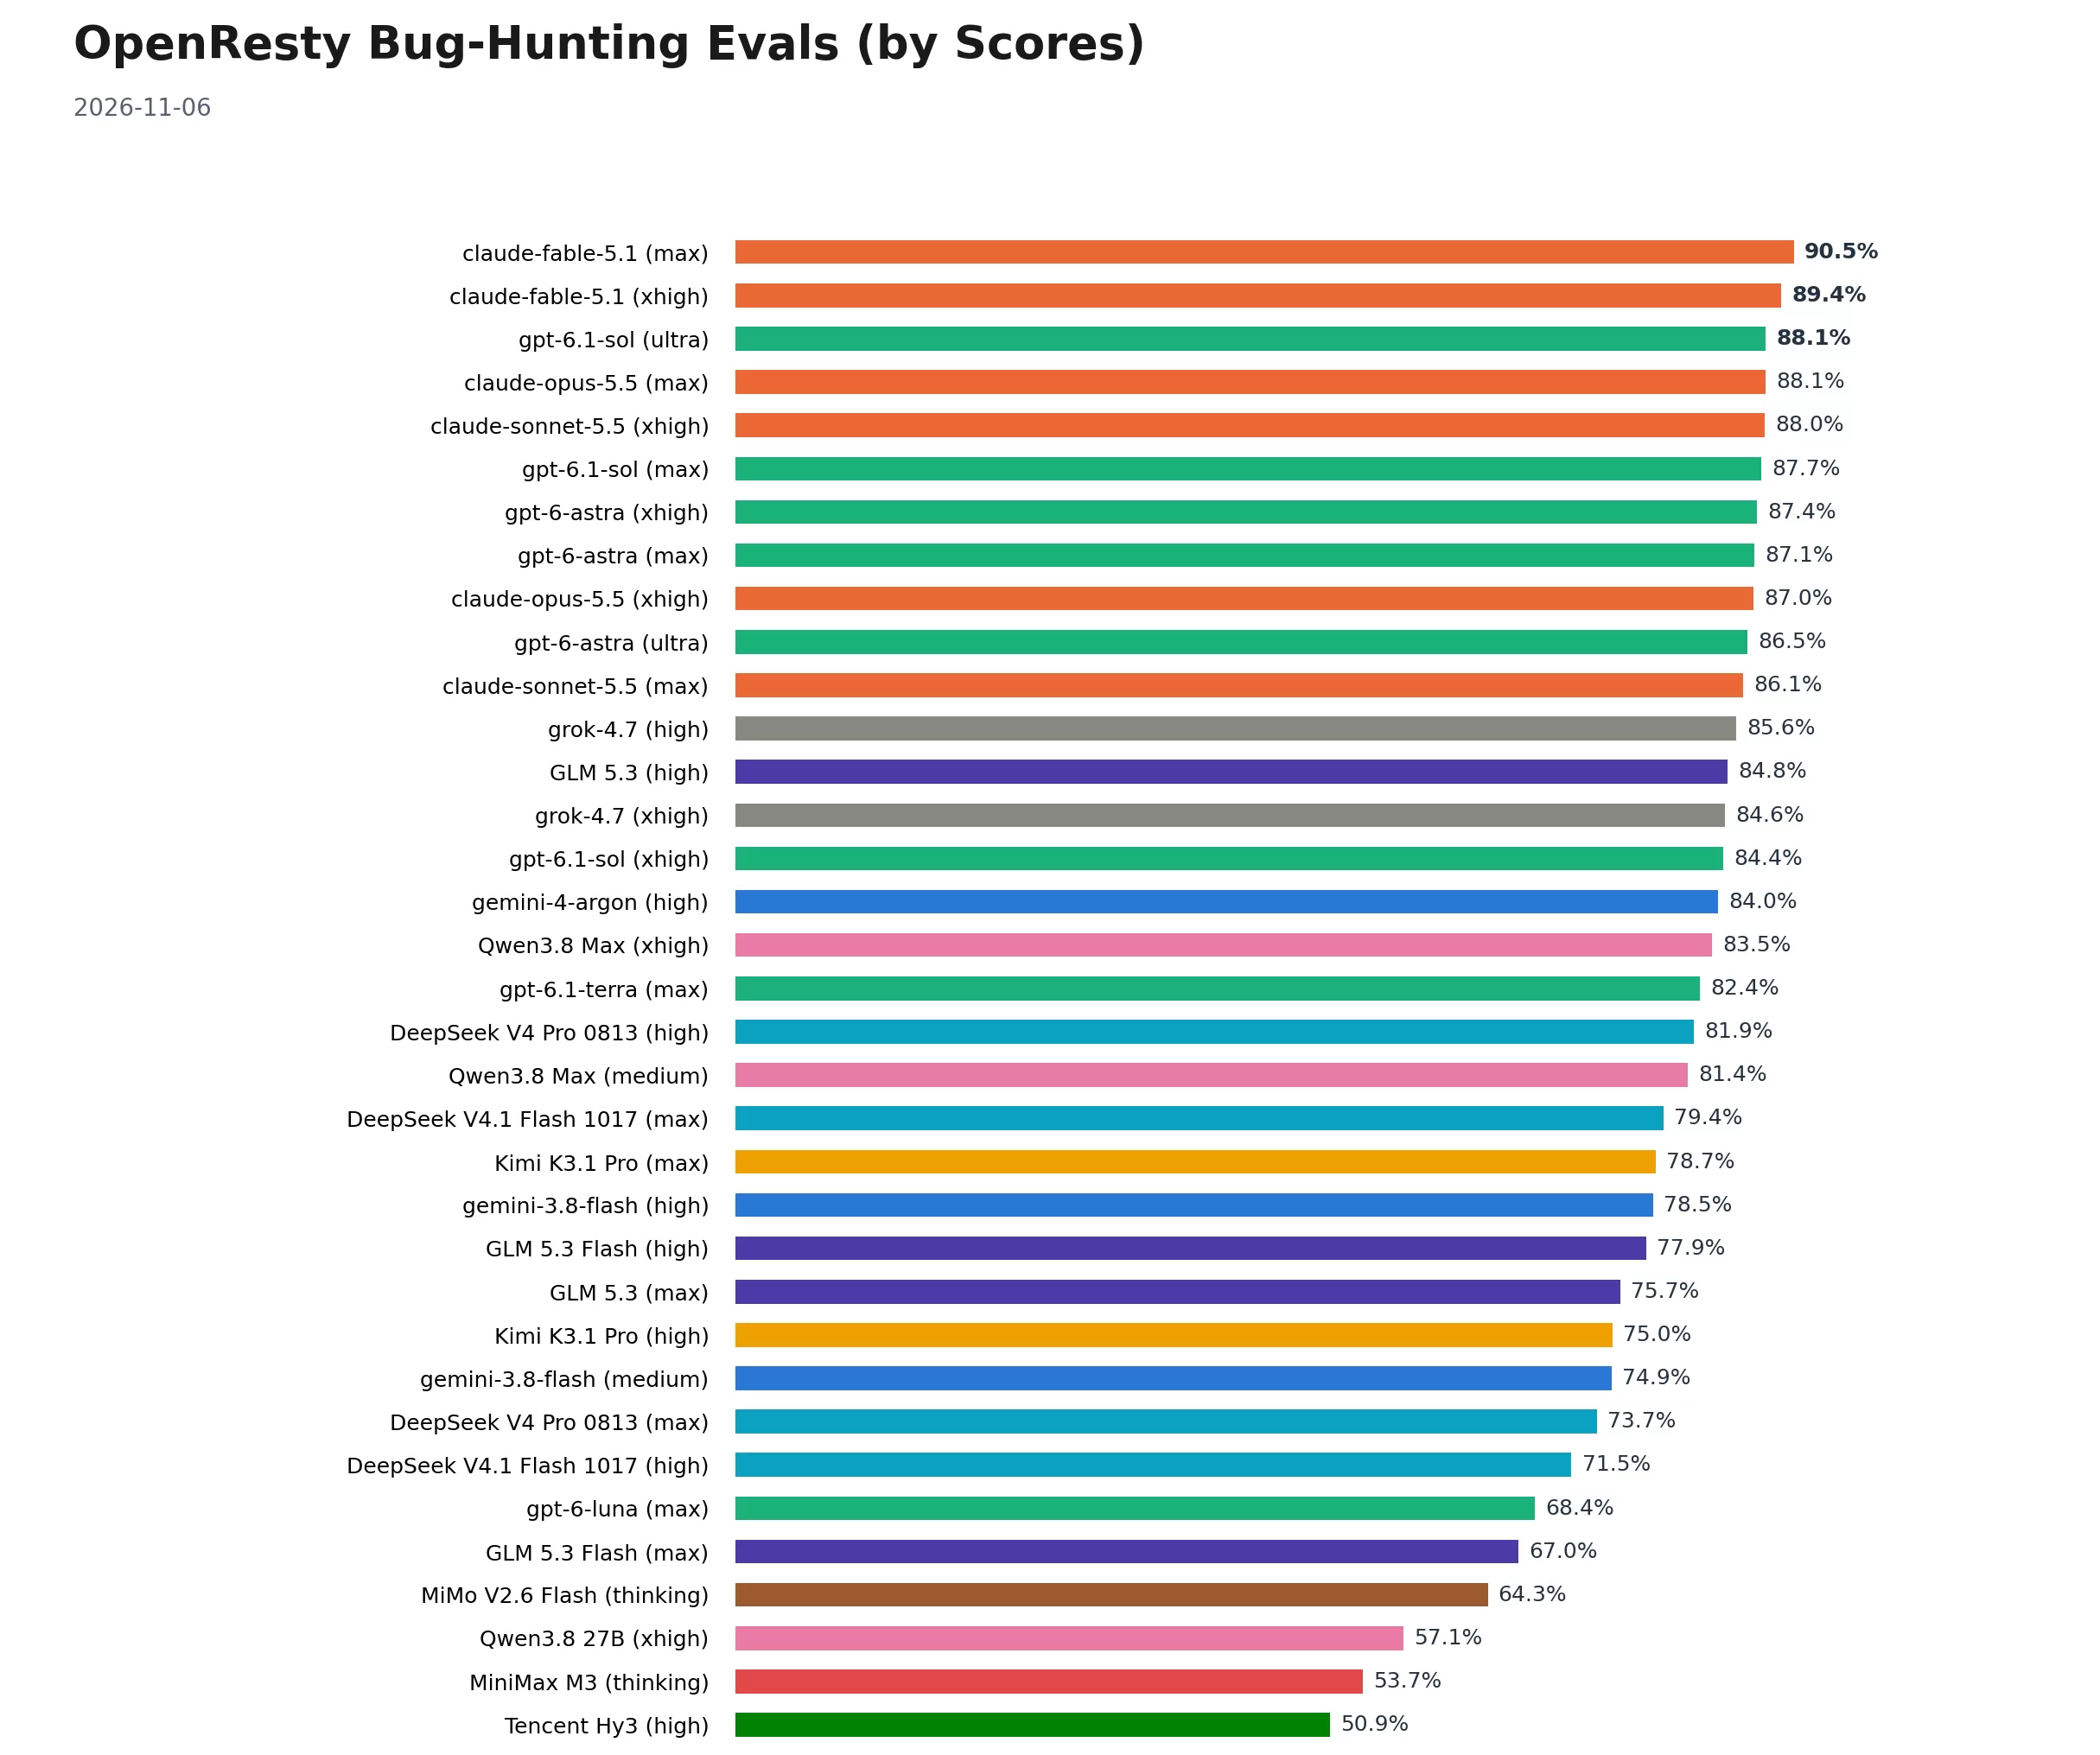
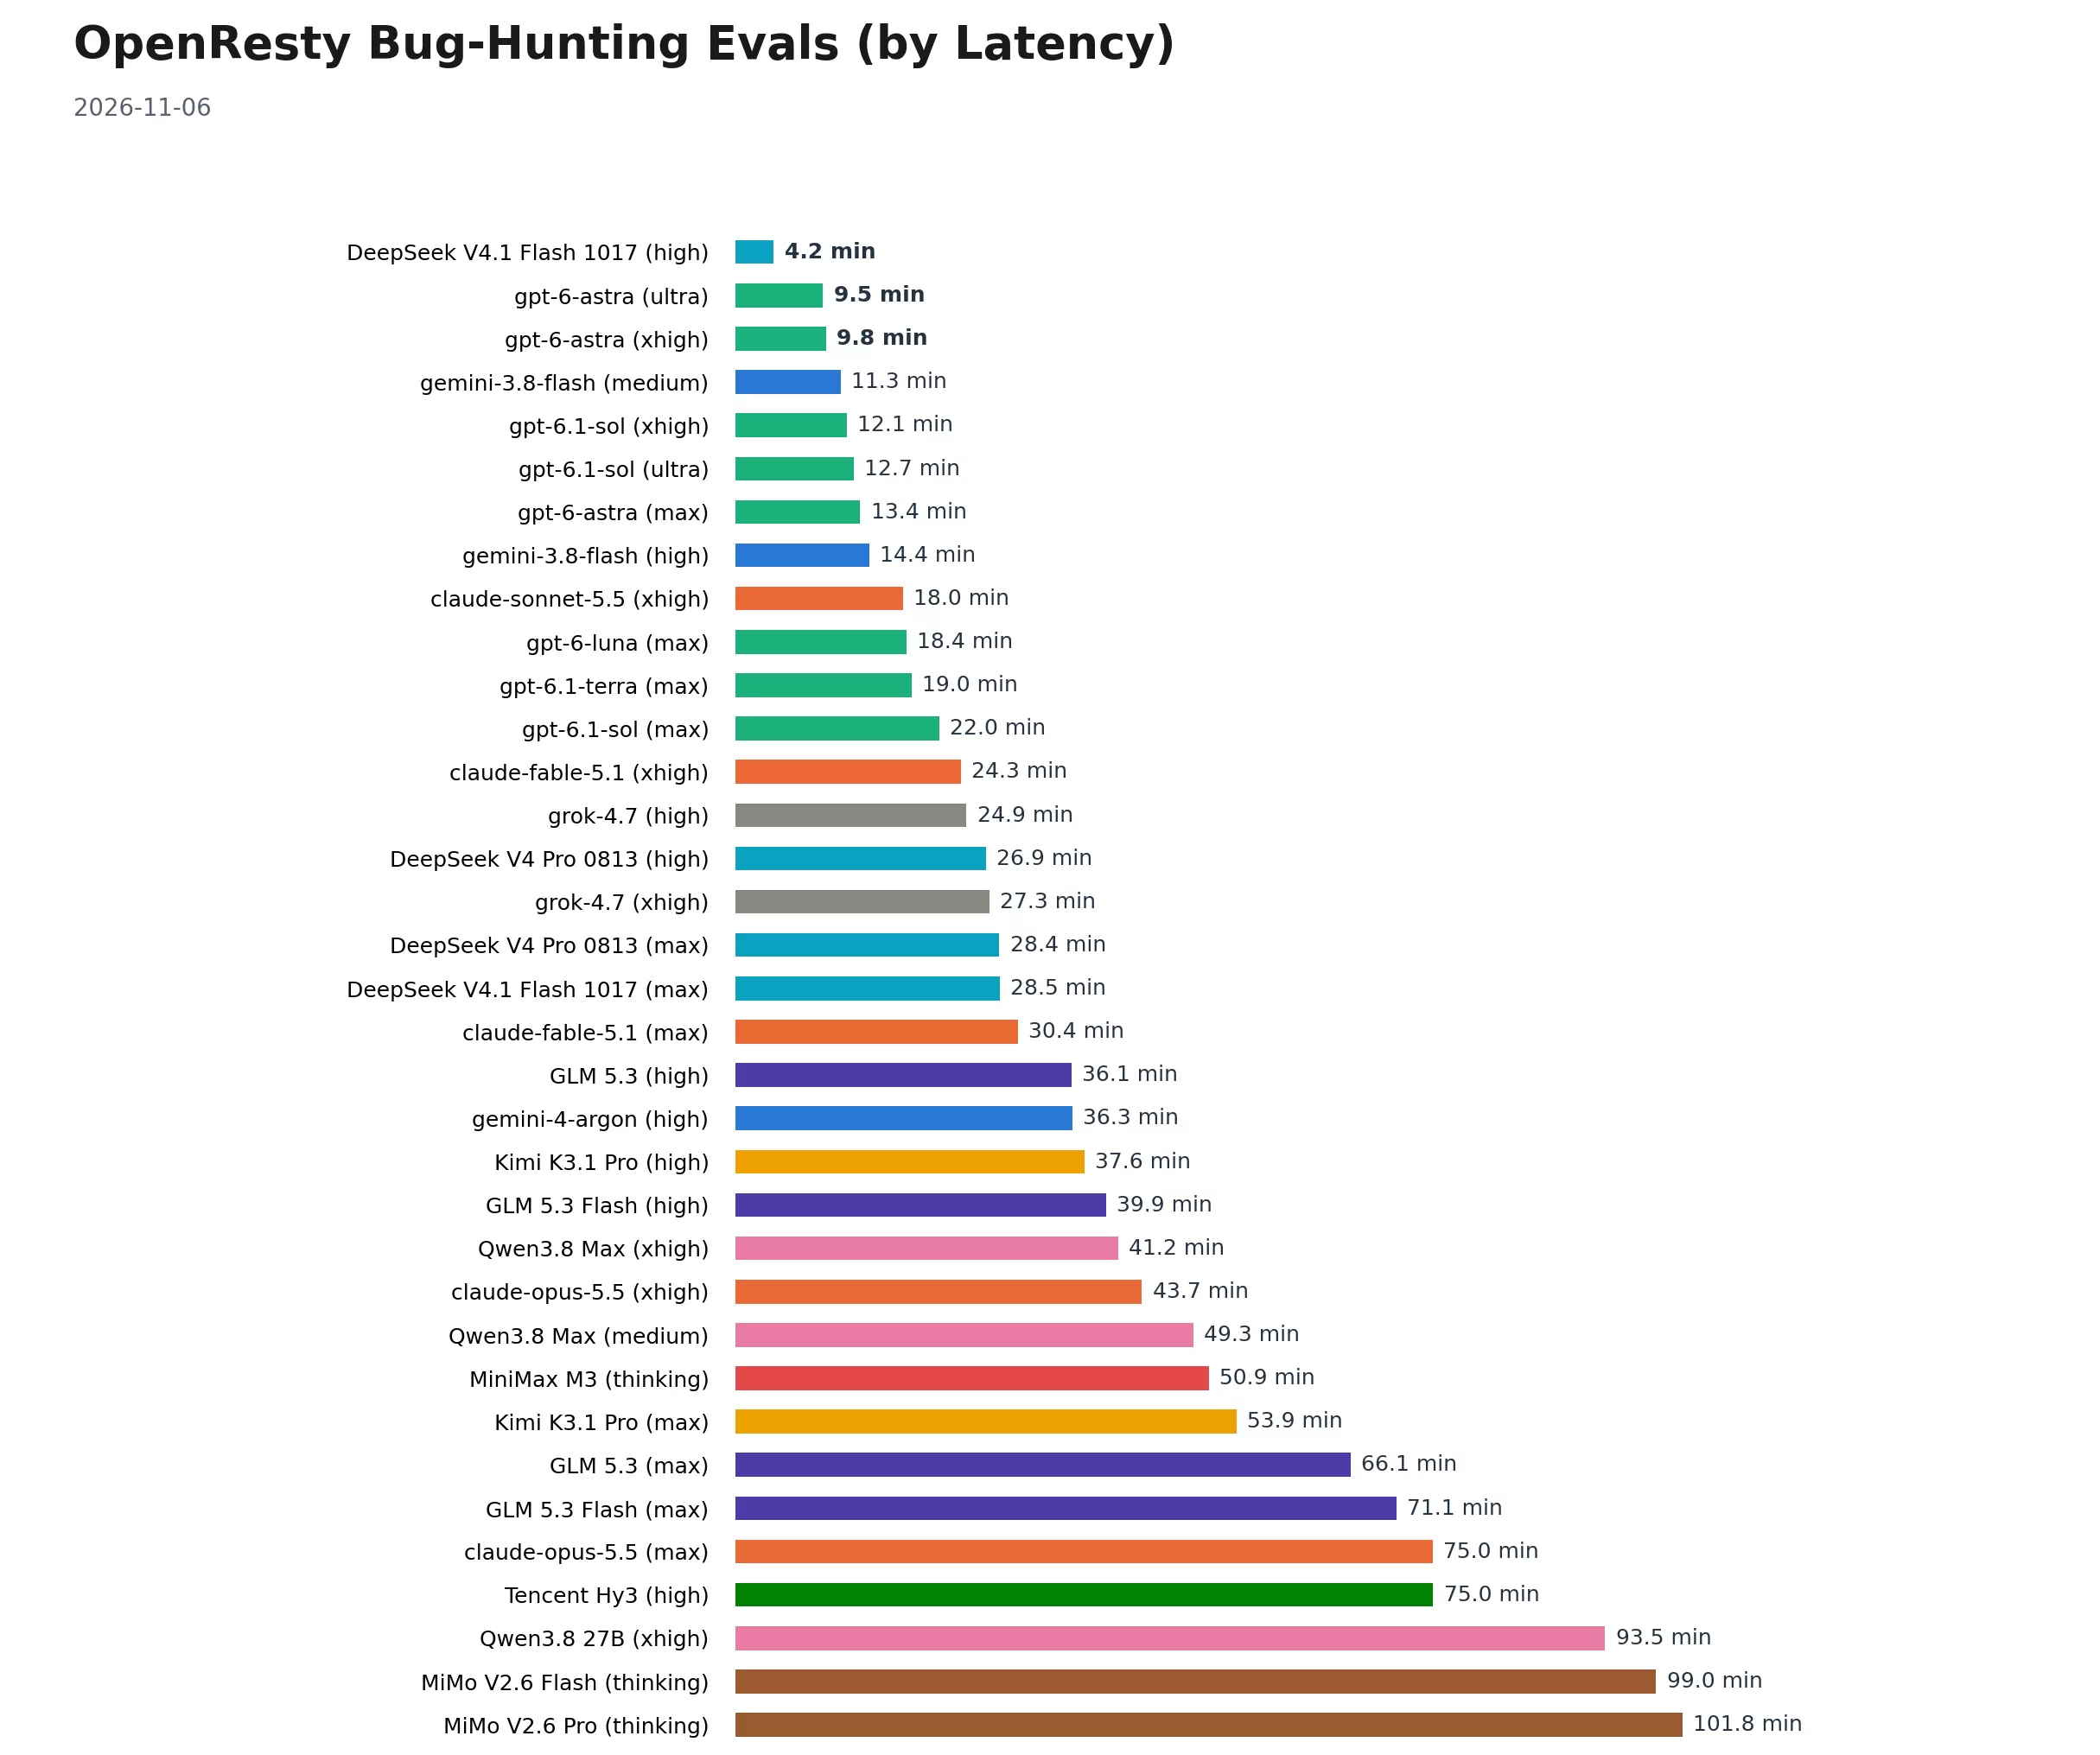
中美大模型榜单更新:Claude Sonnet 5.5 的 xhigh 档抢戏。
作者更新了 OpenResty Coding Evals 和更难的 Bug-Hunting Evals 两张榜单,把中美多款模型的质量评分与平均用例延时放在一起对比,中文数字均以这次更新后的榜单为准。